Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Diretor, Análise de Dados
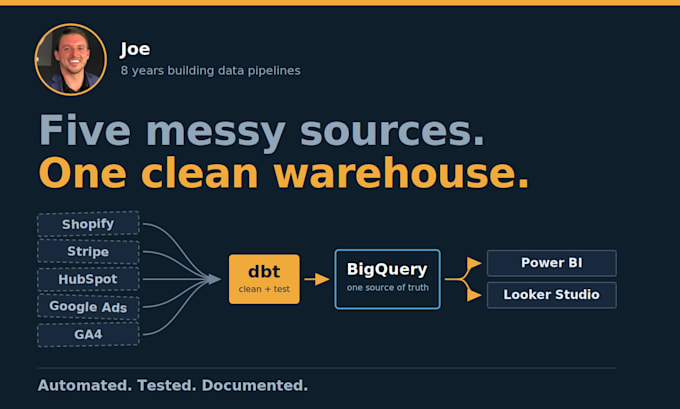
A maioria dos problemas de dados não são problemas de análise. São problemas de infraestrutura. Os números vivem em cinco ferramentas, três delas discordam, e alguém na sua equipe reconstrói o mesmo relatório manualmente toda segunda-feira.
Eu crio o pipeline que faz essa parada parar.
O que eu faço:
Levo seus dados das fontes para o BigQuery de forma automatizada. Modela eles no dbt para ficar limpo, testado e documentado. Entrego de volta estruturado, para que seus relatórios puxem de uma única fonte ao invés de cinco.
Fontes típicas: Shopify, Stripe, HubSpot, Salesforce, Google Ads, Facebook Ads, GA4, Postgres, MySQL, Google Sheets.
Para quem é isso:
Times que já têm dados e não confiam neles. Se você exporta CSVs para montar relatórios, essa é a solução.
Por que me escolher:
Dez anos em análise de dados, grande parte trabalhando em agências, criando pipelines para clientes de CPG, serviços financeiros e mídia de varejo. Já construí isso para empresas onde o relatório ia para o CMO, então tinha que estar certo.
Você recebe código funcionando, documentação e uma explicação passo a passo. Nada de caixa preta que você precisa pagar para eu manter.
Me envie uma mensagem com as ferramentas que você usa e eu te digo se é o que você precisa antes de fazer o pedido.
Tradução automática
Já preciso de uma conta no BigQuery?
Não. Se você não tiver, vou te orientar na criação do projeto durante o onboarding. Você é o dono da conta e da cobrança, não eu. A camada gratuita do Google cobre a maioria das cargas de trabalho pequenas a médias.
Quanto custa para rodar isso depois que estiver pronto?
O pipeline é seu, sem taxa contínua para mim. Você paga ao Google pelo armazenamento e consultas no BigQuery, que para a maioria das pequenas empresas é alguns dólares por mês. Se usar uma ferramenta de conexão paga como Fivetran, ela tem seu próprio preço baseado no volume de linhas. Te aviso o custo esperado antes de começarmos.
Que tipo de acesso você precisa de mim?
Acesso de leitura às suas fontes de dados e administração no projeto do BigQuery. Nunca preciso das suas senhas. Tudo funciona com credenciais de API ou contas de serviço que você pode revogar a qualquer momento.
Meus dados estão bagunçados. Isso é um problema?
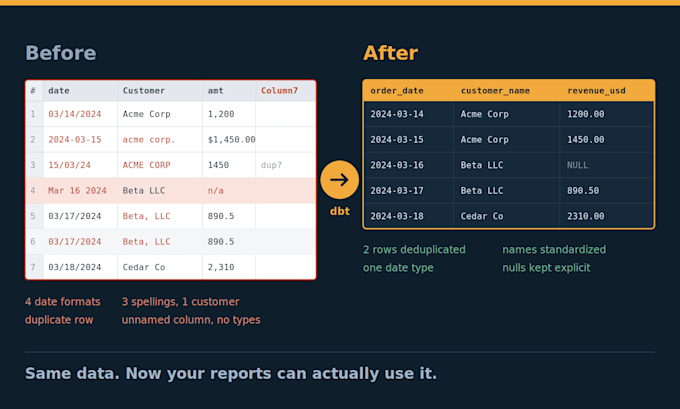
Esse é o trabalho. Registros duplicados, nomes inconsistentes, formatos de data diferentes e colunas que significam coisas distintas em sistemas diferentes são normais. Limpar isso é o que a camada de modelagem do dbt serve.
Você consegue conectar uma fonte que não está na sua lista?
Normalmente sim. Se a ferramenta tiver uma API ou exportar para um banco de dados, ela pode ser conectada. Me envie uma mensagem antes de pedir e eu confirmo.
O que acontece se o pipeline quebrar depois?
Você recebe uma documentação explicando como funciona e como resolver problemas comuns. Também estou disponível para suporte contínuo como um serviço separado, se desejar. Nada fica preso comigo.
Você também constrói os dashboards?
Não neste serviço. Isso deixa seus dados limpos e estruturados para que suas ferramentas atuais funcionem corretamente. Se precisar de dashboards, me envie uma mensagem e podemos definir isso separadamente.
Por que não usar uma ferramenta sem código?
Para uma fonte simples, uma ferramenta sem código pode ser suficiente. Isso é para quando você tem várias fontes que precisam ser unidas, deduplicadas e reconciliadas, o que essas ferramentas não fazem bem.