Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Copiar e colar de PDFs não escala, e OCR genérico estraga as tabelas. trabalhos baratos de entrada de dados funcionam até você precisar que seja repetível, auditável e rodando toda semana sem você.
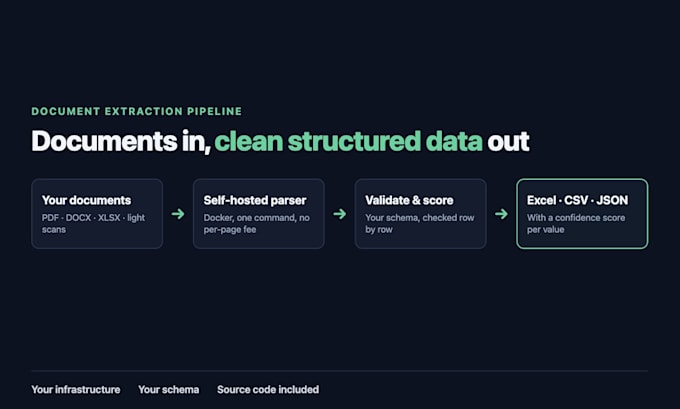
Eu construo a pipeline ao invés disso: documentos de entrada, dados estruturados limpos de saída, na sua infraestrutura.
O QUE VOCÊ RECEBE
- Uma pipeline que você mesmo roda (Docker, um comando)
- Seu esquema, seus campos, validados em cada linha
- Pontuação de confiança em cada valor extraído
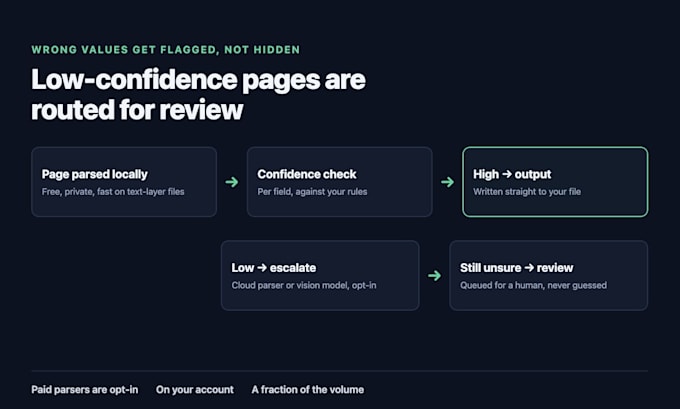
- Páginas de baixa confiança encaminhadas para revisão, não silenciosamente erradas
- Saída em Excel, CSV ou JSON
- Código fonte e documentação de configuração
POR QUE AUTO-HOSPEDADO
O parser roda localmente: sem taxa por página, e seus documentos nunca deixam sua infraestrutura. Parsers pagos na nuvem são usados apenas para páginas que realmente precisam deles — uma fração do volume, na sua conta, a seu critério.
COMO EU FUNCIONO
Comece com o Pilot. Envie de 20 a 50 páginas reais. Eu passo por elas e envio um relatório escrito: o que foi extraído com sucesso, o que não foi, e quais campos precisam de regras de revisão. Então você decide.
NO ESCopo
PDF com camada de texto, DOCX, XLSX, PPTX e digitalizações leves. Escrita manual, formulários e gráficos são cotados separadamente — é só perguntar.
Envie de 3 a 5 páginas de exemplo e os campos que você precisa.
Tecnologia:
Excel
•
Python
Tradução automática
Como isso é diferente de um trabalho de entrada de dados de $20?
Um trabalho de entrada de dados digita seus documentos uma vez. Essa é uma pipeline que você possui e roda para sempre, com regras de validação e pontuações de confiança para você saber quais valores confiar. Uma compra totalmente diferente.
Eu pago por página?
Não para o parser — ele roda na sua própria máquina, então o volume de páginas é gratuito. Apenas páginas que precisam de um parser na nuvem ou modelo de visão custam algo, na sua conta, e você decide se ativa isso ou não.
Que precisão você pode prometer?
Nada antes de eu ver seus documentos, e seja cético com quem diz o contrário. Benchmarks de parsers publicados discordam bastante e os resultados dependem dos layouts específicos. O Pilot mede isso primeiro nas suas páginas reais.
Meus documentos deixam minha infraestrutura?
Não por padrão. O parser é auto-hospedado. Parsers na nuvem são opcionais, por página, e só para páginas que o pipeline local sinaliza como baixa confiança. Se precisar de zero chamadas externas, diga e eu faço assim.
Você consegue lidar com documentos digitalizados?
Digitalizações leves, sim. Digitalizações pesadas, escrita manual e formulários são possíveis, mas precisam de cotação separada. São realmente mais difíceis, e prefiro precificá-las honestamente do que entregar abaixo do esperado.
O que acontece com valores que ele erra?
Eles são sinalizados, não escondidos. Cada valor tem uma pontuação de confiança, e linhas de baixa confiança são encaminhadas para revisão, ao invés de serem inseridas silenciosamente na sua planilha.
Quem roda após a entrega?
Você mesmo. É um container Docker mais seu código, com documentação de configuração. Um comando para começar.