Ver categorias
Português
$
USD
Conecte-se à sua IA
Desenvolvimento Web Full Stack, Engenharia de Dados, Automação em Python
Nível 1
Atendeu a determinados critérios de desempenho e demonstra forte potencial no marketplace.
Proteções anti-bot, páginas dinâmicas com JavaScript ou scrapers quebrados estão atrapalhando suas operações de dados?
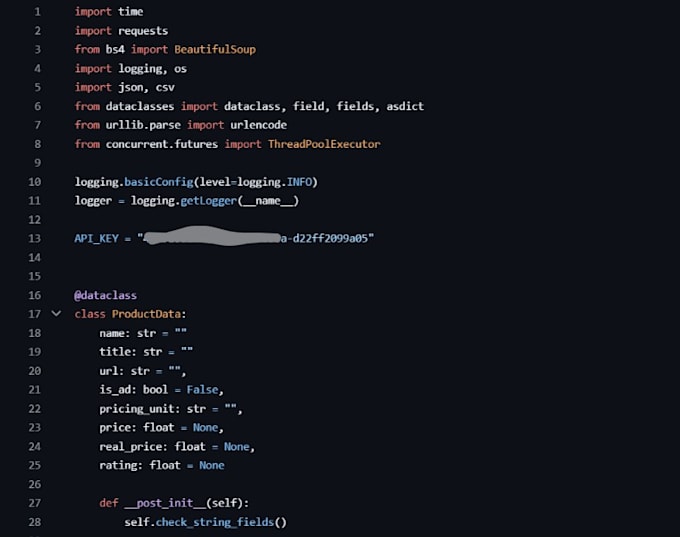
Eu desenvolvo soluções de web scraping em Python resilientes e prontas para produção, usando Scrapy e Selenium, para extrair dados limpos e estruturados com escala, sem intervenção manual.
O que eu Build:
Pilha Técnica:


Tecnologia:
Python
•
Excel
•
scrapy
•
selenium
•
Beautiful Soup
Técnica:
Automatizado
Tradução automática
Você consegue fazer scraping de sites que exigem login ou que usam JavaScript dinâmico?
Sim. Eu uso Selenium e Playwright para gerenciar sessões de login, cookies, fluxos de autenticação de dois fatores (quando possível) e conteúdo dinâmico carregado via React/Vue ou infinite scroll.
Como você evita bloqueios de IP e limites de taxa?
Dependendo do pacote e da arquitetura do site, eu implemento rotação de user-agent aleatória, atrasos personalizados entre requisições, backoff exponencial e integração com o seu provedor de proxy.
Em qual formato receberei os dados finais?
Você pode escolher CSV, XLSX (Excel), JSON ou inserção direta em bancos de dados SQL (PostgreSQL, MySQL, SQLite). Todos os conjuntos de dados são limpos, deduplicados e validados de acordo com o esquema antes da entrega.