Ver categorias
Explorar
Fiverr Pro
Português
$
USD
A Bolha Freelance
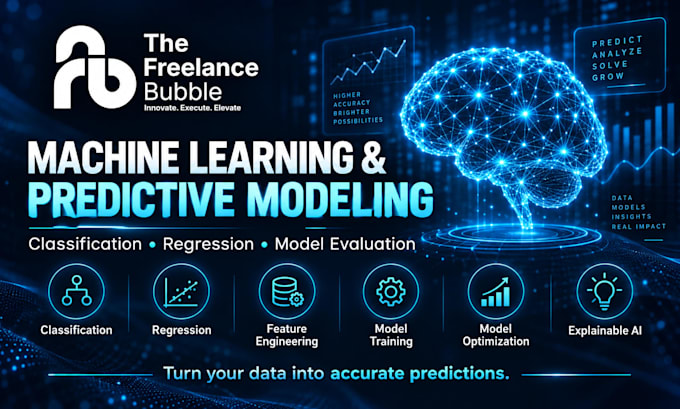
Vou criar modelos de aprendizado de máquina e preditivos precisos, interpretáveis e com documentação profissional, adaptados aos seus dados e objetivos do projeto.
Posso trabalhar com conjuntos de dados de pesquisa, saúde, negócios, científicos e estruturados para transformar dados brutos em previsões significativas e insights acionáveis.
Meus serviços incluem:
Trabalho com Python, R, Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter, Colab e RStudio.
Por favor, entre em contato antes de fazer o pedido para deep learning, conjuntos de dados muito grandes, implantação na nuvem, integração de API ou workflows personalizados.
Tradução automática
Que tipos de projetos de aprendizado de máquina você consegue realizar?
Posso trabalhar com classificação, regressão, clustering, detecção de anomalias, análise preditiva, engenharia de features, modelos de árvore de decisão e avaliação de modelos para conjuntos de dados de pesquisa, saúde, negócios e científicos.
O que preciso fornecer antes de começar?
Por favor, forneça seu conjunto de dados, objetivo do projeto, variável alvo se aplicável, saída desejada e quaisquer requisitos ou perguntas específicas que você queira que o modelo responda.
Quais linguagens de programação e ferramentas você usa?
Eu uso principalmente Python e R com Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter Notebook, Colab, RStudio, SQL e ferramentas relacionadas de ciência de dados.
Você fornecerá o código-fonte?
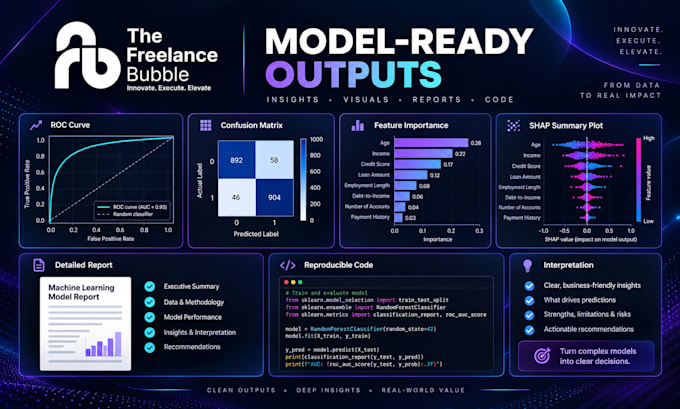
Sim. Código fonte ou notebooks estão incluídos de acordo com o pacote selecionado e serão organizados para reprodutibilidade e revisão.
Você consegue comparar múltiplos modelos de aprendizado de máquina?
Sim. Pacotes padrão e Premium podem incluir múltiplos modelos, validação cruzada, comparação de modelos, otimização e seleção com base em métricas de desempenho apropriadas.
Você fornece IA explicável ou análise SHAP?
Sim. IA explicável, valores SHAP, importância de features e interpretação podem ser incluídos, especialmente no pacote Premium ou por meio de uma oferta personalizada.
Você pode trabalhar com dados de saúde ou pesquisa?
Sim. Posso analisar conjuntos de dados biomédicos, de saúde, pesquisa e científicos. Por favor, garanta que quaisquer dados sensíveis estejam devidamente anonimizados antes de compartilhar.
Você oferece implantação de modelo ou integração de API?
Sim, implantação na nuvem e integração de API podem ser adicionadas como extras ou gerenciadas por meio de uma oferta personalizada, dependendo da complexidade do projeto.
Você pode garantir uma precisão específica do modelo?
Não. O desempenho do modelo depende da qualidade dos dados, tamanho da amostra, equilíbrio de classes, relevância das features e do problema de previsão subjacente. Meu foco é validação rigorosa e relatórios transparentes, não garantias irreais.
Devo entrar em contato com você antes de fazer o pedido?
Sim, especialmente para conjuntos de dados grandes, deep learning, projetos de saúde, implantação, integração de API ou requisitos personalizados de aprendizado de máquina.