Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Sua aplicação de RAG ou LLM está gerando respostas irrelevantes, inconsistentes ou sem suporte?
Vou avaliar sua aplicação existente, identificar onde ela falha e fornecer recomendações práticas para melhorias.
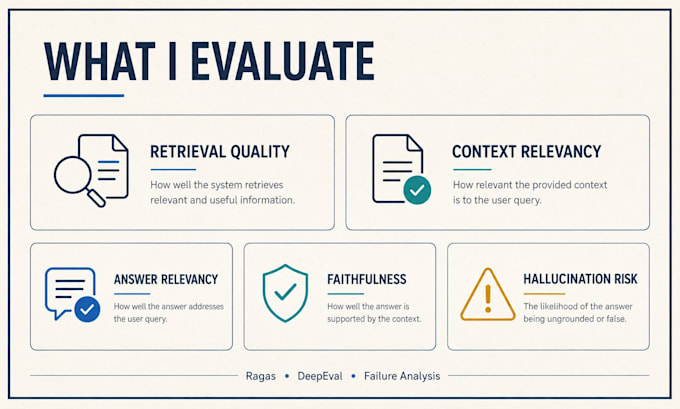
Dependendo do pacote escolhido, a avaliação pode cobrir:
Você receberá mais do que uma lista de pontuações. Explicarei os problemas observados, causas prováveis e próximos passos recomendados.
Trabalho com sistemas RAG e LLM baseados em Python usando LangChain, LangGraph, Qdrant, ChromaDB, FAISS, Langfuse, Ragas e DeepEval.
Este serviço avalia uma aplicação existente. Construir um novo sistema RAG ou implementar mudanças arquitetônicas importantes requer um pedido separado.
Por favor, entre em contato antes de fazer o pedido e compartilhe sua arquitetura, dados de teste disponíveis e problemas atuais.
AI Engineer for RAG AI Agents and MLOps
Idiomas
Tradução automática
Tradução automática
O que você precisa para avaliar minha aplicação?
Preciso de uma descrição da aplicação, seu comportamento esperado, consultas representativas e acesso ao código relevante, API, ambiente de teste ou resultados exportados de query-context-answer.
Você pode avaliar meu sistema sem acesso à produção?
Sim. Posso trabalhar com um repositório local, arquivo fonte, API de teste, ambiente de desenvolvimento ou amostras de avaliação exportadas.
O que é um caso de teste?
Um caso de teste geralmente inclui uma consulta do usuário, o contexto recuperado, a resposta gerada e, quando disponível, o comportamento esperado ou resposta de referência.
Você pode criar o conjunto de dados de avaliação?
Os planos Standard e Premium podem incluir um conjunto de dados estruturado com base nos exemplos e comportamento esperado fornecidos pelo cliente.
Você vai usar Ragas ou DeepEval?
Sim, quando os dados da aplicação e o escopo da avaliação forem adequados. Nem toda métrica é apropriada para todo sistema, então o conjunto final de métricas é escolhido de acordo com o caso de uso.
Você vai consertar todos os problemas que identificar?
Não. O foco do básico e padrão é na avaliação e recomendações. O premium inclui apenas melhorias pequenas, previamente combinadas. Trabalhos de implementação maiores exigem uma oferta personalizada.
Você consegue garantir uma melhora específica na pontuação?
Não. Os resultados dependem dos dados, da arquitetura de recuperação, dos modelos e das mudanças permitidas. Não garanto uma melhora numérica específica.
Você consegue garantir que o sistema não terá alucinações?
Nenhum sistema de IA pode ser garantido totalmente livre de alucinações. A avaliação pode identificar respostas sem suporte e recomendar controles para reduzir o risco.
Você consegue avaliar uma aplicação agentica?
Sim. O escopo do pacote depende do número de agentes, ferramentas e componentes de IA incluídos na solicitação.