Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
Descrição do serviço
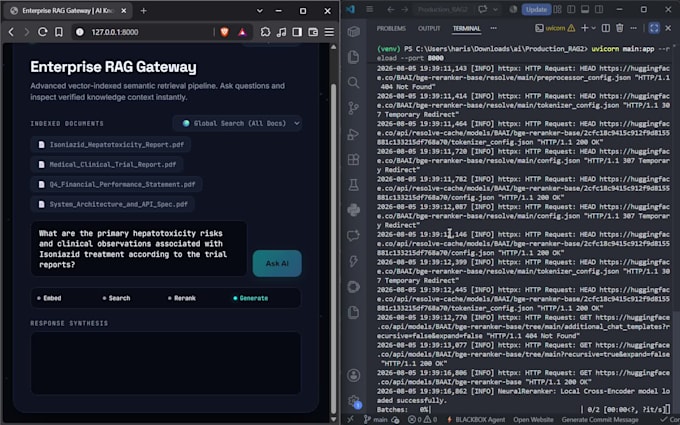
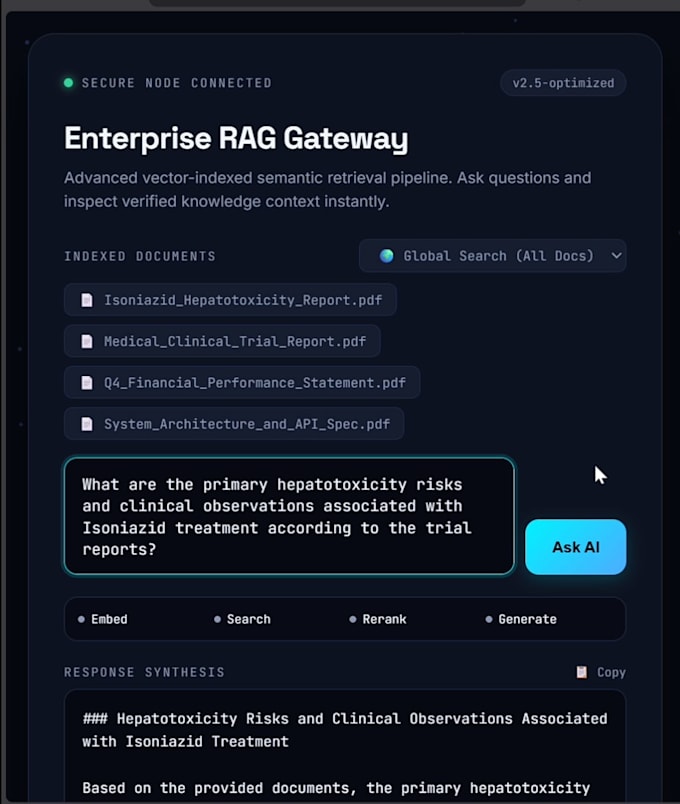
Quer uma IA que possa conversar com seus PDFs, documentos ou banco de dados com precisão? Eu vou criar um sistema RAG pronto para produção para o seu negócio...
Sou especialista em arquiteturas de GenAI para produção e sistemas backend assíncronos usando Python, FastAPI, Vector DBs e LLMs (OpenAI, Groq, Llama 3).
️ Principais funcionalidades:
Pilha tecnológica:
Python | FastAPI | Qdrant | Pinecone | LlamaIndex | LangChain | OpenAI | Groq | Docker
Por que me escolher?
Vamos conversar sobre seu projeto! Me envie uma mensagem antes de fazer seu pedido para que possamos adaptar a arquitetura às suas necessidades específicas de dados.
Enterprise Rag and AI Systems Engineer
Idiomas
Tradução automática
Tradução automática
Q1: Quais pré-requisitos preciso fornecer antes de começar?
Resposta: Você precisará compartilhar as especificações do seu projeto, dados/documentos de exemplo e chaves de API para os provedores de LLM ou Vector DB escolhidos (por exemplo, OpenAI, Groq, Pinecone). Se você não tiver as chaves prontas, posso orientá-lo na configuração segura delas em um arquivo .env.
Q2: Meus dados e chaves de API permanecerão seguros durante o desenvolvimento?
Resposta: Sim, com certeza. Seus dados, lógica de negócio e credenciais permanecem 100% confidenciais. Todas as credenciais sensíveis são carregadas via variáveis de ambiente (.env) e nunca são hardcoded ou compartilhadas.
Q3: Você consegue lidar com parsing personalizado de documentos, como tabelas complexas e PDFs?
Resposta: Sim. Uso ferramentas de parsing conscientes do layout (como LlamaParse) e estratégias de chunking personalizadas para extrair e estruturar tabelas, PDFs, Markdown e textos antes de indexar no banco de dados vetorial.
Q4: A aplicação está pronta para implantação na nuvem?
Resposta: Sim. Cada entrega inclui código Python estruturado, endpoints FastAPI, um modelo .env.example e um Dockerfile otimizado para você implantar instantaneamente na AWS, GCP, Azure ou qualquer servidor local.
Q5: O que acontece se um provedor de LLM ficar fora do ar ou atingir limites de taxa?
Resposta: Eu implemento resiliência embutida usando algoritmos de retry e roteamento de failover multi-provedor (por exemplo, mudando automaticamente de Groq para OpenAI se limites de taxa forem atingidos) para garantir alta disponibilidade.