Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Automação com IA e desenvolvedor full stack
Precisa de um modelo de aprendizado de máquina que transforme seus dados em previsões úteis?
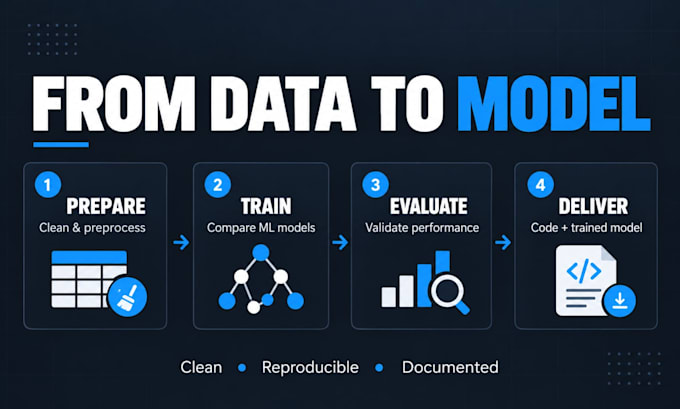
Vou criar um modelo de classificação ou regressão personalizado usando seu conjunto de dados estruturado/tabular e fornecer avaliação clara, código Python reproduzível e resultados documentados.
Posso ajudar com:
Por favor, entre em contato antes de fazer seu pedido se seu conjunto de dados precisar de limpeza extensa, múltiplas fontes de dados, deep learning, NLP, previsão de séries temporais, implantação na nuvem ou processamento em grande escala.
Os resultados dependem do seu conjunto de dados e da configuração de avaliação, portanto, não posso garantir precisão específica ou resultados comerciais.


Linguagem de programação:
Python
•
R
•
MATLAB
•
SQL
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Outros
Ferramentas:
caderno Jupyter
•
opencv
•
OpenNN
•
fluxo tensor
•
Excel
•
Colab
Tradução automática
Em que tipos de problemas de aprendizado de máquina você pode trabalhar?
Este serviço foca em problemas supervisionados de aprendizado de máquina usando dados estruturados/tabulares, principalmente classificação e regressão. Por favor, entre em contato primeiro para previsão de séries temporais, NLP, visão computacional, deep learning ou tipos de dados incomuns.
O que é classificação?
Classificação prevê uma categoria ou classe, como churn/não churn, fraude/não fraude, aprovado/rejeitado, ou uma categoria entre várias possíveis.
O que é regressão?
Regressão prevê um valor numérico, como preço, nível de demanda, pontuação, valor de receita ou outro alvo contínuo.
Que dados devo fornecer?
Por favor, forneça um conjunto de dados estruturado, como CSV, Excel ou outro formato tabular acordado, junto com uma descrição das colunas e do alvo que deseja prever.
Você consegue limpar meu conjunto de dados?
Limpeza está incluída dentro dos limites do pacote. Limpeza extensa, mesclar várias fontes de dados, rotulagem manual ou reconstrução de conjuntos de dados severamente incompletos podem exigir uma oferta personalizada.
Quais algoritmos de aprendizado de máquina você usará?
O algoritmo depende do seu conjunto de dados e da tarefa de previsão. Abordagens adequadas podem incluir modelos de regressão, árvores de decisão, Random Forest, gradient boosting, XGBoost e outros métodos clássicos de ML apropriados.
Você pode garantir uma precisão específica?
Não. O desempenho do modelo depende fortemente da qualidade, quantidade, relevância, equilíbrio e previsibilidade dos dados fornecidos. Usarei métodos de avaliação apropriados e relatarei claramente os resultados alcançados.
Receberei o código fonte?
Sim. Você receberá o código Python reproduzível ou notebook incluído no seu pacote, junto com artefatos do modelo relevantes e documentação.
Você pode implantar o modelo?
O pacote Premium inclui protótipo de API de inferência ou script de previsão em lote. Implantação completa na nuvem, monitoramento, infraestrutura escalável e operações contínuas de MLOps são serviços separados.