Ver categorias
Português
$
USD
Conecte-se à sua IA

Tradução automática
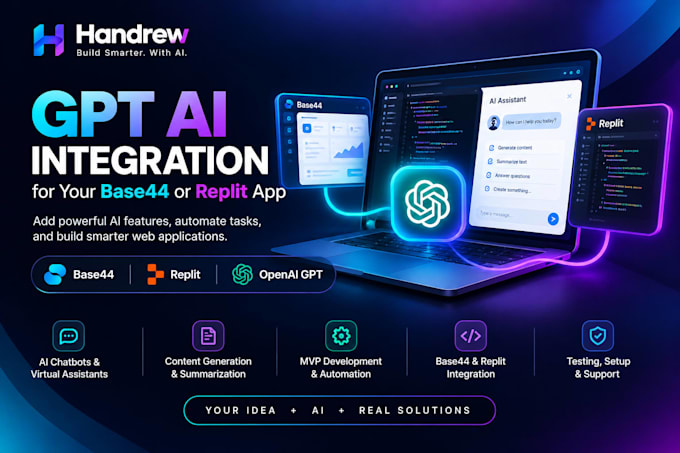
Eu vou integrar o GPT no seu projeto Base44 ou Replit e entregar um protótipo funcional (chat, automação por webhook, memória opcional) que transforma sua ideia em um recurso de IA demonstrável, seguro e pronto para demos ou para produção futura.
O que eu posso construir
O que você vai receber
Por que trabalhar comigo?
PEDIR AGORA
AI App Development , GPT Integration Specialist
Idiomas
Tradução automática
Tradução automática
Você precisa da minha chave API do OpenAI?
Posso usar sua chave ou ajudar a criar uma; as chaves ficam em variáveis de ambiente (por ex., OPENAI_API_KEY) e nunca são comprometidas nem expostas no cliente.
Você pode entregar o protótipo em 48 horas?
Sim — para projetos de escopo baixo (uma página de chat + um webhook) com acesso imediato e requisitos claros.
Como você garante a segurança dos webhooks e das requests?
Implemento verificação HMAC/secret-token, validação de payload, rate limiting e retry/backoff para entrega confiável.
Como você controla os custos do OpenAI?
Uso limites de tokens, resumo de requests, caching e registro básico de uso para que o gasto seja previsível e limitado.
A memória de conversa será armazenada e é privada?
Memória de sessão de curto prazo é opcional; memória vetorial de longo prazo é um add-on — armazenamento e retenção ficam sob seu controle.
