Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
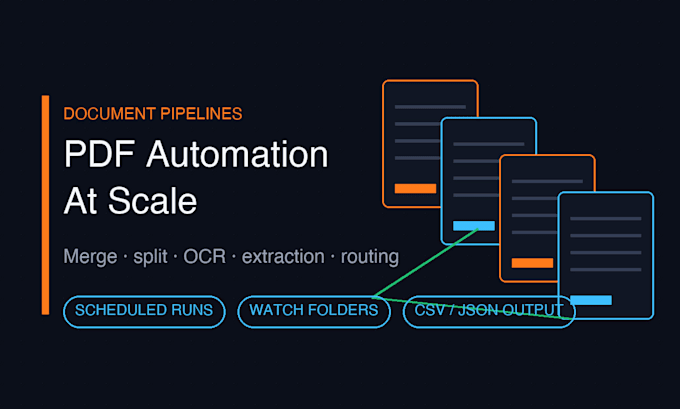
Pare de perder horas com tarefas repetitivas de PDF. Eu construo pipelines automatizados que processam seus documentos do começo ao fim: mesclar, dividir, reordenar, comprimir, OCR de páginas digitalizadas, extrair tabelas e campos para CSV/Excel, renomear, ordenar e encaminhar para o local correto.
O que entrego: Mesclagem personalizada, divisão e manipulação de páginas em escala. OCR para tornar faturas, contratos e formulários digitais pesquisáveis. Extração de dados: tabelas, itens, datas, IDs -> CSV, Excel ou Google Sheets. Processamento em lote para centenas ou milhares de PDFs. Fluxos disparados: e-mail, pasta monitorada, webhook de API ou cron. Tratamento de erros e relatório de falhas em cada execução, sem perdas silenciosas.
Construído em Python com bibliotecas confiáveis, envolvido em n8n ou em um script independente que você pode rodar. Funciona na sua máquina ou em um pequeno servidor, seus dados nunca saem do seu controle.
Ideal para back-office de contabilidade, equipes jurídicas, logística e qualquer operação atolada em papelada.
Me mande uma mensagem com um arquivo de exemplo e o resultado que você quer. Confirmo o escopo antes de você pedir.
Full Stack Developer, Mobile Flutter Kotlin Swift, Web Java Angular, Desktop
Idiomas
Tradução automática
Tradução automática
A pipeline pode rodar em um cronograma?
Sim — eu entrego um script ou serviço que você pode acionar manualmente, em uma programação cron ou via API/webhook.
Qual o volume de arquivos que você consegue lidar?
De um único PDF a lotes de 10.000+. Lotes grandes rodam em blocos com rastreamento de progresso e relatório de falhas.
Você trabalha com PDFs digitalizados ou baseados em imagem?
Sim. adiciono uma etapa de OCR (Tesseract) para que faturas, contratos ou formulários digitalizados fiquem pesquisáveis e passíveis de extração.