Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
Vou avaliar, comparar e otimizar seus prompts de IA ou fluxos de trabalho de LLM para melhorar a confiabilidade, consistência e qualidade do output.
Vou revisar seu prompt existente, testá-lo com exemplos de entrada, identificar pontos fracos ou padrões de falha e fornecer melhorias otimizadas com base em avaliação estruturada e benchmarking.
Dependendo do pacote escolhido, os serviços podem incluir:
Meu processo usa uma estrutura de avaliação proprietária, projetada para medir melhorias com resultados baseados em evidências, ao invés de tentativa e erro na edição de prompts.
Este serviço é adequado para:
O objetivo é ajudar seus sistemas de IA a funcionarem de forma mais confiável em entradas do mundo real e casos extremos.
Observação: os casos de teste são limitados a 5 para Básico, 20 para padrão e 50 para premium.
Data Driven AI Evaluation and Optimization
Idiomas
Tradução automática
Tradução automática
Que tipos de problemas você pode ajudar a melhorar?
Exemplos incluem: Respostas inconsistentes Alucinações Seguimento pobre de instruções Raciocínio fraco Problemas de tom/estilo Formatação JSON inválida Verbosidade excessiva Problemas de confiabilidade em diferentes entradas
Você fornece relatórios?
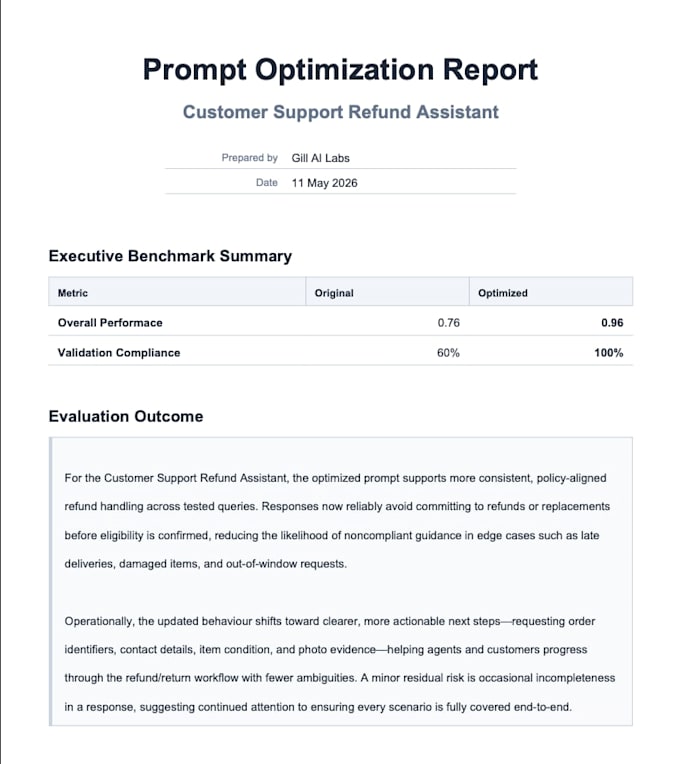
Sim. Dependendo do pacote escolhido, os relatórios podem incluir: Resultados do benchmark Comparações antes e depois Recomendações de otimização Resumos de avaliação Análise de confiabilidade
Você pode testar prompts contra conjuntos de dados ou múltiplos cenários?
Sim. Pacotes de nível superior podem incluir testes estruturados de benchmark em múltiplos casos de teste e casos extremos.
Você garante resultados perfeitos da IA?
Nenhum sistema de IA pode ser garantido para funcionar perfeitamente em todas as situações. O objetivo é melhorar significativamente a confiabilidade, consistência e qualidade geral do output usando métodos estruturados de avaliação e otimização.
Quais modelos de IA você suporta?
Posso trabalhar com prompts e fluxos de trabalho para: ChatGPT da OpenAI Claude da Anthropic Google Gemini
O que você precisa de mim?
Por favor, forneça: Seu prompt ou fluxo de trabalho atual O objetivo do sistema de IA Entradas e saídas de exemplo (se disponíveis) Qualquer requisito de formatação, tom ou negócio Detalhes de quaisquer problemas que esteja enfrentando