Ver categorias
Português
$
USD
Conecte-se à sua IA



Tradução automática
Precisa de um scraper rápido e confiável ou de um pipeline de extração de dados automatizado? Você está no lugar certo!
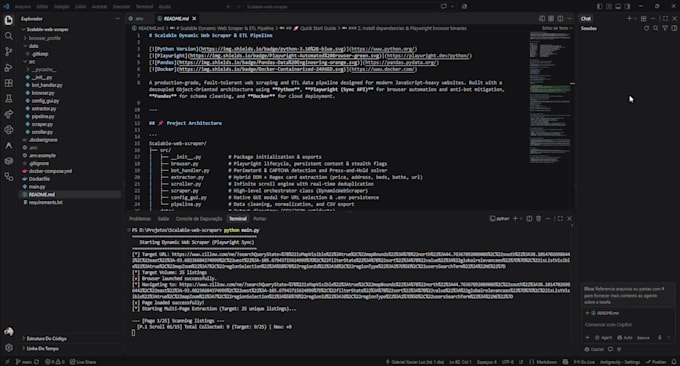
Eu construo scrapers de nível de produção em Python usando Playwright, Pandas e Docker. Diferente de scripts básicos que travam em sites modernos, minhas soluções lidam com JavaScript dinâmico complexo, feeds de rolagem infinita e defesas anti-bot.
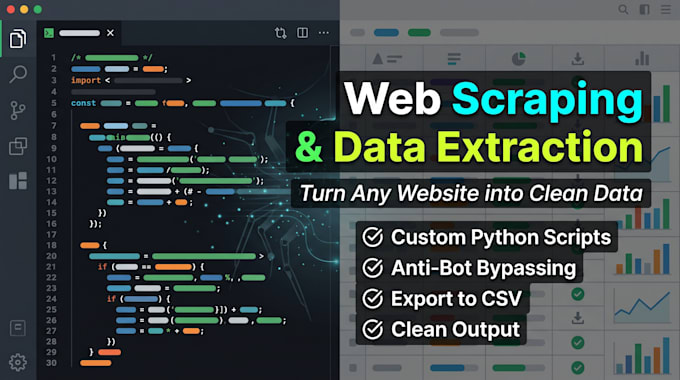
O que entrego: Raspagem Dinâmica de JS: aplicativos de página única, rolagem infinita e itens carregados lazy. Mitigação anti-bot & CAPTCHA: contorna PerimeterX, Cloudflare e overlays de desafio usando cookies persistentes e mecânicas de navegador mais humanas. Limpeza automatizada de dados (Pandas): normaliza o texto cru em números limpos, separa endereços e remove duplicatas. Navegação multirrodapé: paginação automatizada para extrair conjuntos de dados de alto volume. Formatos limpos: CSV pronto para Excel, JSON ou Google Sheets. Pronto para Docker: implantação em contêiner com 1 clique para PCs locais ou servidores na nuvem (AWS/GCP).
Casos de uso: listagens imobiliárias, preços de E-Commerce, diretórios B2B.
️Por favor, me envie a URL alvo e os requisitos antes de fazer o pedido!
Python Developer, Automation and Data Processing
Idiomas
Tradução automática
Tradução automática
Por que devo enviar uma mensagem antes de fazer um pedido?
Cada site tem sua estrutura única, comportamento dinâmico de JavaScript e segurança anti-bot. Rever a URL do site de destino antes ajuda a verificar a viabilidade, checar os campos de dados necessários e oferecer o pacote mais econômico.
Você consegue extrair dados de sites com CAPTCHAs, Cloudflare ou PerimeterX?
Sim! Eu uso Playwright com sessões de navegador persistentes, mecânicas de mouse mais humanas e configurações de bandeira stealth projetadas para contornar overlays de verificação de bots modernos e desafios dinâmicos.
Em quais formatos receberei os dados extraídos?
Eu forneço dados limpos e formatados em CSV pronto para Excel (codificação adequada para evitar erros de formatação), XLSX, JSON ou sincronização direta com Google Sheets. Você também recebe o código-fonte completo em Python e a documentação.
O que eu preciso para rodar este scraper no meu computador?
Você tem duas opções simples: pode rodar localmente com Python padrão ou usar a configuração incluída do Docker (docker compose up) para rodar todo o scraper em 1 único comando, sem necessidade de configuração ou instalação de dependências!
Este scraper pode rodar automaticamente em nuvem em um cron?
Sim! Com o Dockerfile incluso, o scraper fica 100% pronto para nuvem e pode ser implantado no AWS, Google Cloud Run ou DigitalOcean para rodar automaticamente em jobs de cron programados (por exemplo, diário ou semanal).