Ver categorias
Explorar
Fiverr Pro
Português
$
USD
analista de informações
Preço para novos vendedores: os primeiros 5 pedidos têm desconto enquanto eu construo meu histórico de avaliações.
Um modelo que você pode defender, não apenas uma pontuação que precisa confiar.
O que você recebe
- Validação honesta: divisão estratificada ou por tempo, reportada como está
- Feature engineering baseado no seu negócio: RFM, comportamental, transacional, baseado em tempo
- Modelos comparados na mesma divisão, para que a escolha seja justificada e não apenas assumida
- Desequilíbrio de classes tratado corretamente: SMOTE, pesos de classe ou ajuste de limiar
- Importância das features classificada e traduzida em termos de negócio
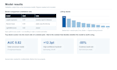
- Um resumo que um stakeholder não técnico consegue entender: AUC, lift, precisão no K
Ferramentas: Python (Pandas, scikit-learn, NumPy, LightGBM), SQL
Histórico: modelos de churn e recall com AUC 0.80, previsão de conversão de pedidos com 47 features em AUC 0.82, e um modelo de pontuação de leads que aumentou a taxa de transferência de alta confiança de 7,7% para 20%.
O que preciso: uma coluna alvo, algumas milhares de linhas de histórico e a decisão que a pontuação vai influenciar. Se seus dados ainda estiverem confusos, posso limpá-los na camada Premium ou você pode pedir meu Gig de limpeza de dados primeiro.
Me envie uma mensagem com a quantidade de linhas e a coluna alvo, e eu confirmarei o escopo antes de você fazer o pedido.
Linguagem de programação:
Python
•
SQL
Frameworks:
Scikit-learn
•
Panda
Ferramentas:
caderno Jupyter
•
Excel
Tradução automática
Qual algoritmo você vai usar?
De acordo com o problema, não por hábito: modelos lineares regularizados como baseline, ensemble de árvores (LightGBM, scikit-learn), SVM ou k-NN para dados não lineares pequenos, clustering para segmentos, ranking para listas ordenadas. Escolhido na validação, nunca por moda — e te digo o que rejeitei.
Qual precisão posso esperar?
Não prometo um número antes de ver os dados, e quem faz isso está chutando. O que me comprometo é com validação honesta e um relatório claro de onde o modelo falha. Para referência, meus próprios projetos atingiram AUC de 0.80 a 0.82 em problemas de churn e conversão.
Meu conjunto de dados é pequeno ou desequilibrado. Ainda assim, você consegue trabalhar com ele?
Normalmente sim. Desequilíbrio é tratado com SMOTE, pesos de classe ou ajuste de limiar, e não ignorado. Dados pequenos são uma limitação real — se houver poucos casos positivos, te aviso claramente antes de pedir, ao invés de entregar um modelo que não dá para confiar.
Receberei o código?
Sim, em todos os pacotes. Você recebe um notebook ou script que pode rodar de novo, além da lista final de features. O tier Premium inclui script de produção, documentação escrita e uma call de entrega.
Você consegue colocar o modelo em produção pra mim?
Não faço deploy na nuvem nem integração via API, e prefiro deixar isso claro antes do pedido, pra não te decepcionar depois. O que você recebe é um modelo e um script prontos para sua equipe de engenharia implantar.
Meus dados são sensíveis. Como você lida com isso?
Envie um extrato mascarado ou uma amostra pequena, se preferir. Só peço as colunas que o modelo realmente precisa, não compartilho seus arquivos com ninguém e apago a cópia de trabalho assim que o pedido for concluído.


