Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Dados IA, Pipelines RAG, PDF para Markdown, LLMs Locais
Proteja seus dados proprietários da empresa com uma IA 100% privada, ajustada finamente localmente.
Enviar documentos sensíveis de negócios, material instrucional ou conhecimento interno para APIs de nuvem pública é um grande risco de segurança e frequentemente viola as regulamentações do GDPR.
Construo modelos de IA seguros, offline, adaptados ao seu setor específico. Aproveitando a arquitetura avançada Apple Silicon (128 GB de Memória Unificada) e frameworks como MLX e Unsloth, seus dados nunca deixam meu hardware isolado e local durante o treinamento.
O que entrego:
Minha Stack Tecnológica & Expertise:
Por favor, envie uma mensagem antes de fazer seu pedido.


Linguagem de Programação:
Python
Estruturas e ferramentas para modelos de IA:
Tipo de dados:
Texto
Motor de IA:
Outros
Tradução automática
Por que devo ajustar fino localmente ao invés de usar OpenAI ou outras APIs de nuvem?
APIs de nuvem representam um grande risco de segurança para dados proprietários da empresa e frequentemente violam políticas rígidas do GDPR. O ajuste fino local garante que seus documentos sensíveis, dados de clientes e conhecimento interno nunca saiam de um ambiente isolado e offline. Você mantém 100% da soberania dos seus dados.
Você consegue ajustar modelos maiores em hardware local?
Sim. Aproveito uma arquitetura Apple Silicon de ponta com 128 GB de Memória Unificada. Com frameworks avançados de quantização como MLX e Unsloth (QLoRA), essa largura de banda de memória enorme me permite ajustar e executar modelos de código aberto grandes (como Llama, Mistral ou Qwen) de forma eficiente totalmente local.
Em que formato deve estar meus dados de treinamento?
Para o pacote Padrão, seus dados devem estar preparados como um arquivo JSONL limpo contendo pares de instrução-resposta estruturados. Se seu conhecimento estiver atualmente preso em PDFs bagunçados, texto bruto ou documentos internos, meu pacote Premium inclui pré-processamento Python personalizado para extrair, limpar e formatar esses dados.
Quais arquivos exatamente vou receber na entrega?
Você receberá os pesos do adaptador LoRA ajustado fino juntamente com um arquivo de modelo totalmente mesclado e quantizado (formato GGUF). Este arquivo GGUF está pronto para implantação e pode ser arrastado e solto instantaneamente em motores de inferência local como Ollama, LM Studio ou AnythingLLM no seu hardware da empresa.
Como você garante que o modelo realmente aprenda meu domínio e não apenas overfit?
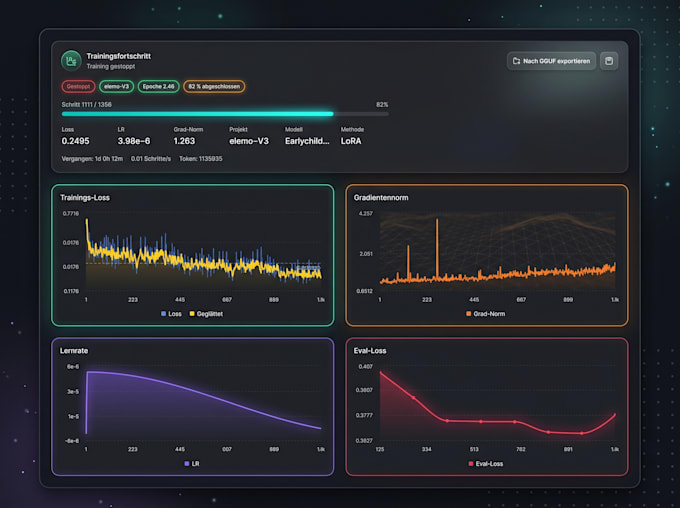
Monitoro rigorosamente as curvas de perda de treinamento e ajusto hiperparâmetros para garantir que o modelo generalize bem para sua terminologia específica.