Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
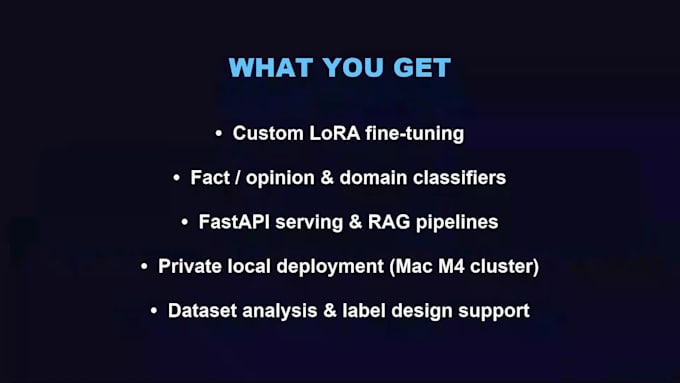
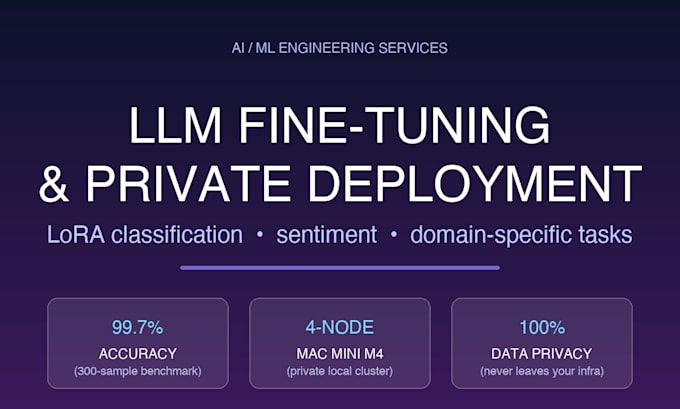
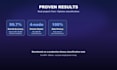
Customização de LLM com LoRA/QLoRA para classificação, análise de sentimento, transferência de estilo e tarefas específicas de domínio. Criei um classificador binário de fatos/opiniões com Qwen3-14B-4bit LoRA que atingiu 99,7% de precisão, e tudo é implantado no meu cluster privado de 4 nós Mac Mini M4, garantindo que seus dados nunca saiam do seu ambiente.
O que eu ofereço:
Por que me escolher:
Antes de fazer seu pedido: envie uma mensagem com sua tarefa, tamanho e formato do dataset, idioma alvo e prazo, para que eu possa confirmar a viabilidade e o tempo de entrega.
AI ML Engineer, LLM Fine tuning and Private Deployment Specialist
Idiomas
Tradução automática
Tradução automática
Quais dados você precisa de mim?
Amostras rotuladas ou não rotuladas em CSV/JSON, ou uma descrição da tarefa.
Meus dados ficarão privados?
Sim, todo o trabalho é realizado no meu cluster privado local, os dados nunca deixam sua infraestrutura.
O que eu recebo após a entrega?
Pesos do modelo ajustado, relatório de avaliação e guia/API de implantação, se aplicável.
Quais modelos você ajusta?
Modelos populares de código aberto como Qwen, Llama, Mistral e outros, usando LoRA/QLoRA eficiente.
Quanto tempo vai demorar?
Tarefas típicas de pequeno a médio porte são entregues em 3 a 7 dias, dependendo do volume de dados e da carga do cluster.
Você consegue lidar com dados de texto em idiomas diferentes do inglês?
Sim, posso ajustar modelos multilíngues como Qwen, BLOOM ou MiniLM multilíngue para tarefas de classificação e NLP em idiomas não ingleses. Compartilhe seu idioma e domínio, e eu configurarei o modelo adequado para você.
Quais opções de implantação você oferece?
Implantação privada usando FastAPI + Docker (ou MLX/vLLM para maior throughput na produção) nas suas próprias máquinas - Mac Mini, Linux ou servidores Windows. Também configurei um endpoint de API interno para sua equipe.
Qual precisão posso esperar?
Depende da qualidade dos dados e da dificuldade da tarefa. Como referência, meu classificador de fatos/opiniões com Qwen3-14B LoRA atingiu 99,7% de precisão. Você sempre recebe um relatório completo de avaliação com precisão, F1 e análise de erros.
Por que usar LoRA/QLoRA em vez de fine-tuning completo?
LoRA/QLoRA atualiza apenas uma pequena fração dos parâmetros, reduzindo o custo de treinamento e o uso de memória em até 90%, mantendo a qualidade próxima do fine-tuning completo. Treina mais rápido e gera artefatos menores, o que torna a implantação privada em hardware modesto mais viável.