Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
Quer melhorar sua aplicação com busca semântica de alto desempenho, embeddings vetoriais personalizados e correspondência rápida de similaridade?
Sou especialista em criar arquiteturas de bancos de dados vetoriais de nível de produção, pipelines de busca semântica e algoritmos de similaridade personalizados usando Python, FastAPI, Qdrant e PostgreSQL (pgvector).
O que eu ofereço:
Integração de banco de dados vetorial: configuração e ajuste de Qdrant, PostgreSQL (pgvector), Chroma ou FAISS.
Pipelines de embedding: segmentação de texto, otimização de tokens, modelos locais (SentenceTransformers, E5, BGE) ou na nuvem (OpenAI).
Algoritmos de similaridade personalizados: cálculo de similaridade cosseno, distância euclidiana e produto escalar.
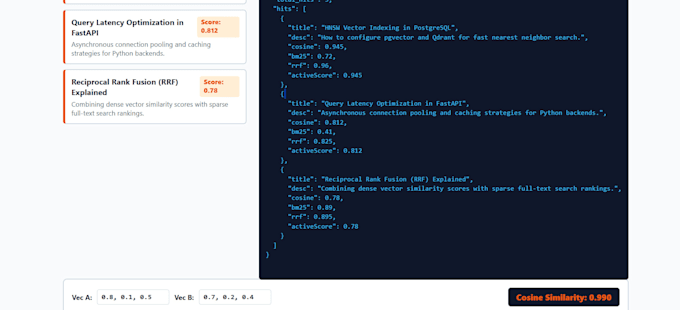
Busca híbrida: combinação de busca tradicional de texto completo com recuperação de vetores densos usando Reciprocal Rank Fusion (RRF).
APIs de produção: endpoints REST assíncronos desenvolvidos com Python, FastAPI e validação Pydantic.
Pilha tecnológica:
Python, FastAPI, Qdrant, PostgreSQL (pgvector), SentenceTransformers, Hugging Face, PyTorch, Docker.
Por favor, envie uma mensagem antes de fazer seu pedido para discutirmos seu conjunto de dados e requisitos!
AI Backend Engineer RAG Vector Search
Idiomas
Tradução automática
Tradução automática
Por que usar busca vetorial ao invés de busca por palavras-chave tradicional?
A busca tradicional procura por correspondência exata de palavras. A busca vetorial analisa o significado semântico, encontrando contexto relevante mesmo quando os usuários usam sinônimos ou frases diferentes.
Isso pode rodar 100% localmente para garantir privacidade total dos dados?
Sim. Posso configurar modelos de embedding locais (como E5 ou BGE via SentenceTransformers) e bancos de vetores locais (Qdrant ou pgvector) para que nenhum dado saia do seu servidor.
O que é Busca Híbrida e por que é melhor?
Busca Híbrida combina busca de vetores densos (significado semântico) com busca de palavras-chave esparsas (BM25 ou texto completo do PostgreSQL) usando Reciprocal Rank Fusion (RRF) para máxima precisão.