Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
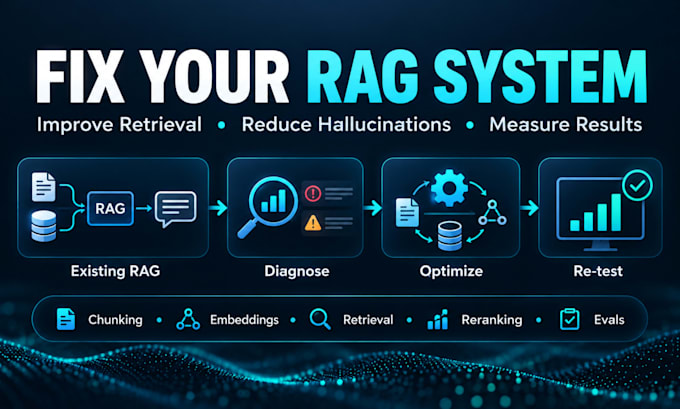
Seu sistema RAG está buscando os documentos errados, tendo alucinações, produzindo citações pouco confiáveis ou respondendo muito devagar?
Vou diagnosticar e otimizar sua pipeline RAG existente usando testes mensuráveis de antes e depois, não mudanças aleatórias de prompt.
Posso ajudar a melhorar:
- Estratégia de chunking
- Embeddings e busca por vetor
- Precisão na recuperação
- Filtragem por metadados
- Busca híbrida
- Reranking
- Construção de prompt e contexto
- Redução de alucinações e grounding
- Qualidade das citações
- Latência e uso de tokens
- Performance do banco de dados vetorial
- Avaliação do RAG
Meu processo:
Medir -> Diagnosticar -> Corrigir -> Retestar -> Comparar
Trabalho com sistemas RAG baseados em Python, LangChain, LlamaIndex, FastAPI, OpenAI, Claude, LLMs locais, Pinecone, Qdrant, Chroma, Weaviate, pgvector e stacks similares.
Você receberá evidências claras de:
- O que causou o problema
- O que foi alterado
- Como o sistema se saiu antes e depois
- Quaisquer limitações remanescentes
Este serviço é para sistemas RAG existentes. Para sistemas de produção grandes, múltiplas integrações ou reconstruções de arquitetura, entre em contato comigo antes de fazer o pedido.
AI and Data Science Engineer, RAG, MCP and LLM Automation
Idiomas
Tradução automática
Tradução automática
1. Você constrói um sistema RAG novo do zero?
Este serviço foca em diagnosticar e melhorar uma pipeline RAG existente. Desenvolvimento de sistema novo deve ser tratado como um projeto personalizado.
2. Você consegue reduzir as alucinações?
Sim. Investigo se as alucinações vêm da recuperação, chunking, construção de contexto, prompting, citações ou comportamento do modelo e corrijo a causa real.
3. Você consegue melhorar a precisão da recuperação?
Sim. Posso revisar chunking, embeddings, busca por vetor, filtros de metadados, busca híbrida, reclassificação e configurações de recuperação.
4. Você trabalha com Pinecone, Qdrant, Chroma, Weaviate ou pgvector?
Sim, dependendo da sua arquitetura atual e requisitos do projeto.
5. Você consegue otimizar latência e custo de API?
Sim. Latência, uso de tokens, tamanho do contexto, chamadas desnecessárias ao LLM e eficiência da recuperação podem ser revisados e otimizados.
6. Você consegue garantir uma melhora específica na precisão?
Não. Primeiro meço a linha de base atual e depois reporto a melhora real alcançada em casos de teste representativos.
7. O que você precisa de mim para começar?
Por favor, forneça seu código fonte ou repositório, arquitetura RAG atual, banco de dados vetorial, modelo de embedding, exemplos de documentos da base de conhecimento, perguntas de teste representativas e alguns exemplos das falhas que você quer corrigir. Se você tiver respostas esperadas, logs ou resultados de avaliação, também serão úteis