Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
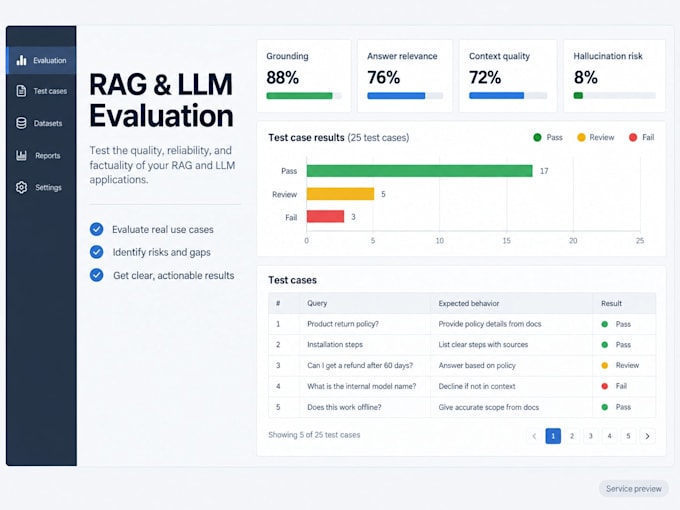
Sua aplicação RAG ou LLM está gerando respostas não suportadas, irrelevantes ou inconsistentes? Eu avaliarei seu comportamento e fornecerei recomendações baseadas em evidências para melhorias.
Posso avaliar:
Relevância, clareza e completude das respostas
Fundamentação no contexto recuperado
Alucinações e afirmações não suportadas
Qualidade da recuperação e utilidade das fontes
Consistência nas citações
Padrões de falha e comportamento de fallback
Indicadores de latência e custo quando os dados estiverem disponíveis
Decisões de chunking, contexto e configuração do modelo
Dependendo do pacote, revisarei casos de teste fornecidos, criarei um conjunto de avaliação estruturado, analisarei falhas na recuperação e geração, e utilizarei métricas automatizadas quando forem tecnicamente apropriadas. Você receberá um relatório claro separando observações, evidências, limitações e recomendações priorizadas.
Por favor, forneça acesso a um ambiente de teste seguro ou resultados exportados da aplicação, contextos recuperados, respostas esperadas quando disponíveis, e uma descrição dos usuários e do caso de uso pretendido. Remova chaves de API, credenciais de produção e dados privados de clientes.
Este serviço avalia um sistema existente. Implementar mudanças importantes, reconstruir o pipeline RAG, implantação em produção ou similares.
Python Backend Applied AI Developer
Idiomas
Tradução automática
Tradução automática
Q: O que conta como um caso de avaliação?
A: Um caso inclui uma pergunta do usuário, a resposta gerada e o contexto ou fontes recuperadas usadas para produzi-la. Respostas esperadas ou de referência são úteis, mas nem sempre necessárias.
Q: Você precisa de acesso ao meu sistema de produção?
A: Não. Prefiro um ambiente de teste seguro, resultados exportados ou uma versão local reproduzível. Por favor, remova chaves de API, credenciais de produção, informações pessoais e dados confidenciais de clientes antes de compartilhar qualquer coisa.
Q: Quais métricas de avaliação você usa?
A: As métricas dependem da aplicação e dos dados disponíveis. A avaliação pode cobrir relevância da resposta, relevância do contexto, fidelidade, fundamentação na fonte, qualidade da recuperação, padrões de alucinação, latência e indicadores de custo. Ferramentas automatizadas podem incluir RAGAS ou métodos equivalentes quando apropriado.
Q: Você implementará as melhorias recomendadas?
A: Este serviço foca na avaliação e recomendações. Pequenas ajustes acordados podem ser oferecidos separadamente, enquanto mudanças maiores no pipeline, novas funcionalidades e implantação exigem uma proposta personalizada.
Q: Você pode garantir que a avaliação eliminará as alucinações?
A: Nenhum avaliador responsável pode garantir que um LLM nunca alucinará. Identificarei padrões de falha observados, os medirei quando possível e recomendarei formas práticas de reduzir sua frequência e impacto.