Ver categorias
Português
$
USD
Conecte-se à sua IA
Engenheiro de Dados Sênior
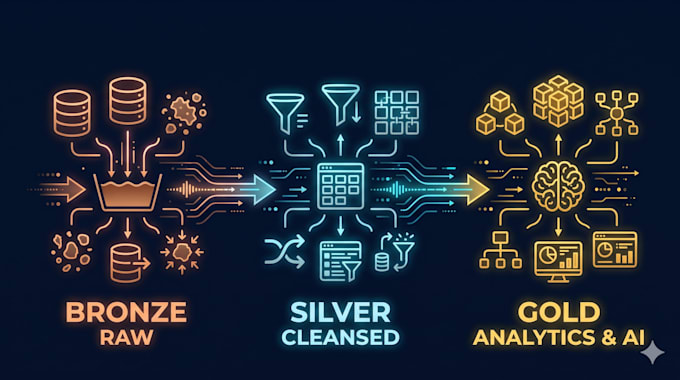
D%C3%A9 dificuldade com consultas SQL lentas, silos de dados bagun%C3%A9ados ou altos custos na nuvem? Sou engenheiro de dados corporativo (certificado pela Microsoft Azure) especializado em PySpark, Azure Databricks, Delta Lake e SQL. Eu desenho, otimizo e construo arquiteturas de dados à prova de falhas que transformam dados brutos em pipelines prontos para analytics e IA.
O que posso fazer por você:
Por que trabalhar comigo?
Me mande uma mensagem antes de fazer o pedido para alinharmos sua stack de dados e o escopo!
Tradução automática
Você pode escrever o código PySpark/SQL real além do plano de arquitetura?
Sim! Além de auditar e criar blueprints de arquitetura, eu escrevo scripts PySpark em produção, notebooks Databricks e consultas SQL otimizadas. Envie seus requisitos para receber uma oferta de implementação personalizada.