Ver categorias
Português
$
USD
Conecte-se à sua IA

Tradução automática
Seu recurso de LLM passou no demonstração. Ele continuará passando após o próximo prompt ou mudança de modelo?
Eu desenvolvo suítes de avaliação que respondem a isso. Você recebe uma rubrica escrita para o seu caso de uso, um conjunto de testes com respostas esperadas e, se um LLM classifica suas saídas, uma verificação de quão confiável é esse juiz.
O que você recebe:
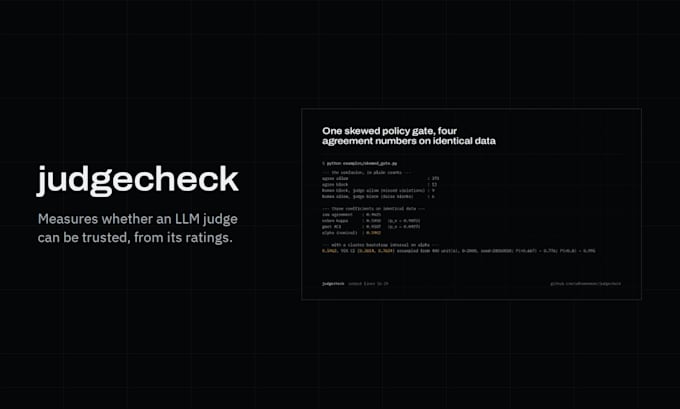
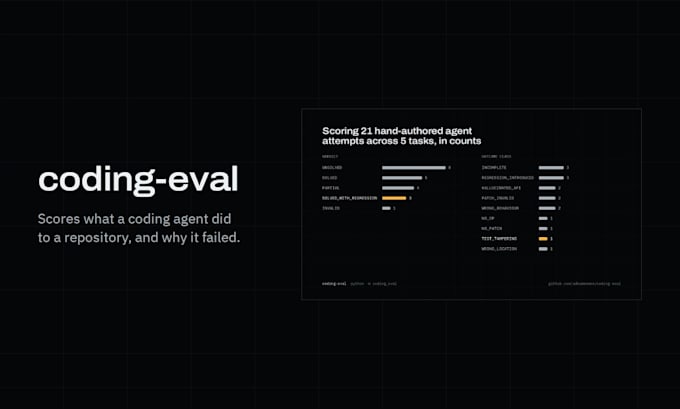
Por que eu: eu criei judgecheck, um relatório de confiabilidade para juízes de LLM que mostra como 96% de concordância bruta pode esconder pontuações corrigidas pela chance tão baixas quanto 0,60, e coding-eval, que reencena tentativas de agentes de codificação em um sandbox (20 de 21 supostamente bem-sucedidos; 5 tiveram sucesso). Eu avalio código de modelos de fronteira profissionalmente e crio rubricas e ferramentas de calibração para IA clínica em árabe.
Envie uma mensagem com o que a funcionalidade faz, alguns inputs e outputs de exemplo e como uma boa resposta parece para você.
AI Red Teaming and LLM Evaluation Engineer
Idiomas
Tradução automática
Tradução automática
O que você precisa de mim?
Acesso ao modelo ou API que você usa (ou um arquivo com saídas salvas), alguns inputs reais de exemplo e qualquer avaliação humana que você já tenha. Se não tiver nenhuma, combinamos uma rodada de avaliação pequena juntos.