Ver categorias
Português
$
USD
Conecte-se à sua IA
Engenheiro(a) especialista em IA e Em aprendizado de máquina
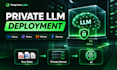
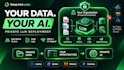
Eu implanto LLMs de código aberto de forma privada, dentro da sua própria conta de nuvem ou em seus próprios servidores. Nada é enviado para APIs de IA de terceiros.
Eu opero essa stack sozinho: um modelo 32B Qwen servido com o vLLM, por trás de uma API compatível com OpenAI, com chaves de API, dashboards de monitoramento (Prometheus e Grafana) e tudo empacotado em uma única imagem Docker.
O que você recebe:
Opcional: um chatbot RAG que responde a partir de seus documentos e mostra suas fontes.
Útil para empresas que lidam com dados privados ou regulamentados (clínicas, jurídico, documentos internos).
Envie uma mensagem primeiro com sua GPU ou nuvem e o modelo que você tem em mente, e eu confirmo a configuração correta.
Frameworks:
Scikit-learn
•
DeepPy
•
Google ML Kit
•
PyTorch
Tipo de dados:
Código
Linguagem de programação:
Python
•
R
•
SQL
•
Amazon SageMaker
Ferramentas:
caderno Jupyter
•
fluxo tensor
•
Amazon SageMaker
•
Colab
Tradução automática
Preciso de minha própria GPU ou conta na nuvem?
Funciona de qualquer jeito. Posso implantar no seu próprio servidor ou em uma conta de nuvem que você possua (AWS, RunPod e similares). Manda uma mensagem primeiro que eu aconselho o tamanho da GPU para o seu modelo.
Meu dado sairá dos meus servidores?
Não. O modelo roda dentro do seu ambiente e nada é enviado para APIs de IA de terceiros. Preciso apenas de acesso para a configuração, e você pode removê-lo depois.
Quais modelos você pode implantar?
Modelos de código aberto como Qwen, Llama e Gemma, com quantização. A melhor escolha depende da memória da sua GPU e do seu caso de uso.
O assistente pode responder a partir dos meus próprios documentos?
Sim, esse é o complemento opcional de RAG. Ele responde a partir dos seus arquivos e mostra a fonte. Informe os tipos de documentos e o volume antes de pedir.
O que você precisa de mim para começar?
Detalhes da sua GPU ou nuvem, o modelo que você tem em mente (se houver) e quais apps vão chamá-lo. Vou confirmar a configuração antes de começarmos.


