Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
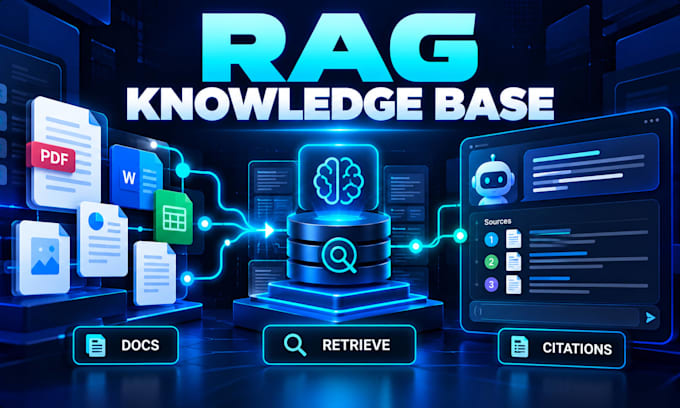
Construa uma base de conhecimento de IA que responda a partir de seus documentos com referências de fontes.
Eu crio sistemas RAG para Q&A de documentos e busca interna de conhecimento. PDFs, DOCX, FAQs, SOPs, manuais, páginas da web ou bancos de dados selecionados são processados e indexados para que as respostas apontem para fontes relevantes.
O QUE POSSO CONSTRUIR
Eu uso Python, APIs de LLM e estruturas RAG adequadas; a stack depende dos seus dados e aplicativo.
Limites de documentos/fonte se aplicam. Grandes migrações, grafos de conhecimento, interfaces SaaS personalizadas e permissões multi-inquilino complexas requerem escopo personalizado.
Envie tipos de documentos, volume, perguntas de amostra, stack atual, papéis de usuário e resultado desejado antes de fazer o pedido.
AI Systems Specialist, Automation, Generative AI and Content Workflow for Smart
Idiomas
Tradução automática
Tradução automática
Você pode construir uma base de conhecimento a partir dos meus PDFs e documentos de negócios?
Sim. Posso construir uma base de conhecimento RAG usando PDFs compatíveis, arquivos DOCX, FAQs, SOPs, manuais, páginas da web ou outras fontes acordadas. Arquivos digitalizados, tabelas complexas e formatos incomuns podem exigir processamento adicional.
As respostas vão incluir citações de fontes?
Respostas com base na fonte e citações estão incluídas no escopo acordado. O nível de detalhe das citações depende do analisador de fontes e de se os arquivos originais expõem metadados confiáveis de página ou seção.
O sistema pode evitar criar respostas?
Posso configurar respostas fundamentadas na recuperação e um fallback quando a evidência recuperada não sustenta a resposta. Nenhum sistema de IA pode garantir zero erros, então testes representativos e limitações claras são importantes.
Você pode corrigir um chatbot RAG existente queretrieve informações erradas?
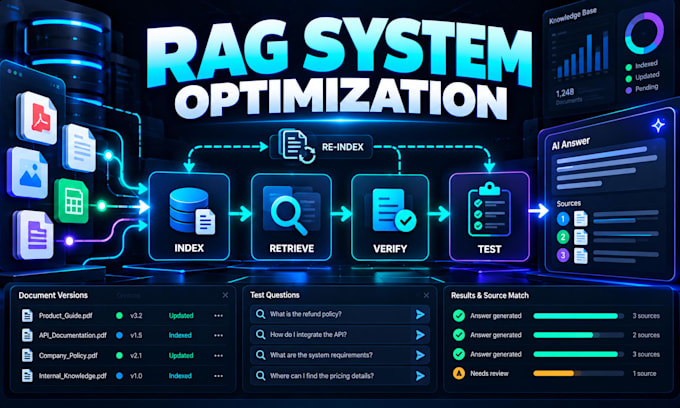
Sim. Posso investigar extração, chunking, embeddings, busca, filtragem, ranking e comportamento de geração de respostas. O pacote adequado depende se o trabalho é uma correção contida ou uma reconstrução mais ampla.
Documentos podem ser atualizados sem reconstruir toda a base de conhecimento?
Sim, onde a arquitetura escolhida suporta. Posso configurar atualizações de documentos e reindexação para que novas versões substituam conteúdo desatualizado em vez de manter informações defasadas nos resultados de recuperação.
Você pode usar Supabase e pgvector?
Sim, quando for apropriado para o projeto. Supabase suporta busca vetorial com pgvector e também busca semântica, por palavras-chave e híbrida.
Você pode restringir o acesso a documentos diferentes?
O filtro de acesso pode ser implementado quando for suportado pela autenticação do aplicativo e pela arquitetura de dados. Deve ser aplicado na camada de backend ou de recuperação, em vez de depender apenas de instruções no prompt.
Você pode migrar uma base de conhecimento ou sistema de Q&A existente?
Sim. Posso revisar as fontes atuais, o design de recuperação, o banco de dados e as dependências antes de propor a migração. Migrações maiores exigem escopo personalizado após a avaliação do sistema existente.
Este Gig inclui um aplicativo SaaS multi-tenant completo?
Não. Este Gig foca no sistema de conhecimento e recuperação. Um produto SaaS completo com gestão de usuários, isolamento de inquilinos, cobrança, dashboards e desenvolvimento de aplicativos fica em um Gig separado de AI SaaS.
O que você precisa antes de começar?
Por favor, forneça seu objetivo, tipos de documentos e volume aproximado, perguntas de amostra, stack atual, integrações necessárias, papéis de usuário e preferências de implantação. Não envie senhas ou chaves de API secretas por chat aberto.