Ver categorias
Português
$
USD
Conecte-se à sua IA

Tradução automática
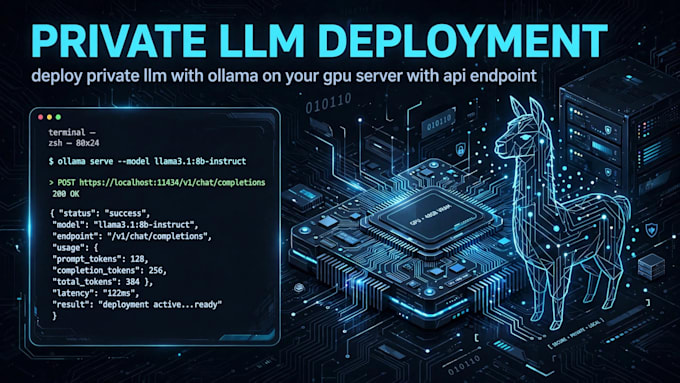
Quer seu próprio modelo de IA privado rodando 24/7? Eu instalo Ollama (ou llama.cpp) na sua instância de GPU na nuvem, puxo o modelo de sua escolha e o exponho como um endpoint de API compatível com OpenAI - com uma interface opcional de chat web.
O que você recebe:
- Ollama / llama.cpp instalados e ajustados na sua instância de GPU
- Modelo de sua escolha puxado e em funcionamento
- Endpoint de API compatível com OpenAI para seus apps
- Opcional: interface de chat Open WebUI
- Dicas de aluguel de GPU caso você ainda não tenha um servidor (você aluga na sua própria conta, eu recomendo a opção mais barata para o seu modelo e orçamento)
O que preciso de você:
- Acesso à instância de GPU (login SSH)
- Qual modelo você quer rodar (ou seu caso de uso - eu vou recomendar um)
Python Developer , Web Scraping and Automation Specialist
Idiomas
Tradução automática
Tradução automática
Eu preciso do meu próprio servidor com GPU?
Sim - você aluga a instância de GPU na sua própria conta (RunPod, Vast.ai, etc.). Eu recomendo a opção mais barata para o seu modelo e orçamento, aí instalo e configuro tudo.
Quais modelos você pode implantar?
Qualquer modelo que Ollama ou llama.cpp suportem - Llama, Qwen, Mistral, DeepSeek distills e mais. Diga qual é o seu uso e eu recomendo um.
Meus apps podem usar o modelo via API?
Sim - eu exponho um endpoint compatível com OpenAI, então tudo que funciona com a API da OpenAI funciona com o seu modelo privado.
