Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Crio automações que economizam tempo e reduzem trabalho manual
Nível 1
Atendeu a determinados critérios de desempenho e demonstra forte potencial no marketplace.
Vou criar um pipeline de dados automatizado que coleta, limpa, transforma e envia seus dados de negócio para onde for necessário.
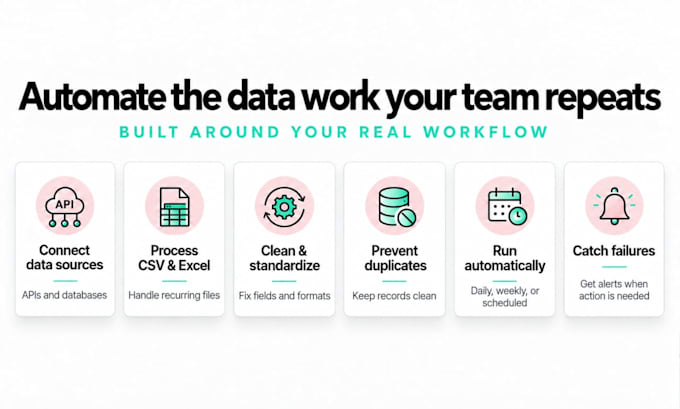
Posso trabalhar com APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, armazenamento na nuvem e outros sistemas compatíveis.
Dependendo do pacote, seu pipeline pode incluir:
Extração de dados e conexões com APIs
Limpeza, mapeamento, filtragem e deduplicação
Validação e verificações de qualidade dos dados
Execuções automáticas agendadas
Registro de erros e alertas de falhas
Testes, documentação e implantação
Este serviço é ideal para tarefas recorrentes de dados, fluxos de relatórios, atualizações de banco de dados e movimentação de dados entre sistemas.
Por favor, envie uma mensagem antes de fazer o pedido com sua fonte de dados, destino, dados de exemplo e o processo que deseja automatizar, assim posso confirmar o pacote adequado.


Ferramentas e plataformas:
Outros
Tradução automática
O que é um pipeline de dados ou pipeline ETL?
É um processo automatizado que coleta dados de uma fonte, limpa ou transforma esses dados e envia para outro sistema. Por exemplo: API → limpar e validar dados → PostgreSQL.
Com quais fontes de dados você pode trabalhar?
Fontes comuns incluem REST APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, armazenamento na nuvem e outros sistemas com APIs acessíveis ou conexões de banco de dados.
O pipeline pode rodar automaticamente?
Sim. Os pacotes Padrão e Premium podem incluir execuções agendadas, como processamento a cada hora, diariamente ou semanalmente.
Você pode limpar, combinar ou transformar meus dados?
Sim. Isso pode incluir renomear campos, formatar datas, filtrar registros, remover duplicatas, juntar conjuntos de dados, converter valores e aplicar regras de negócio.
Você consegue conectar uma API ao meu banco de dados?
Normalmente sim. Por favor, envie os detalhes da API e do destino antes de fazer o pedido para que eu possa confirmar o acesso e a viabilidade.
O que acontece se o pipeline falhar?
Dependendo do pacote, posso incluir registro de logs, validação, alertas de falha, lógica de retries e outras medidas de tratamento de erros.
Vou receber o código fonte e a documentação?
Sim. O código fonte acordado e a documentação de configuração estão incluídos, assim você não fica preso à entrega.
Que tipos de projetos não estão incluídos nesses pacotes?
Data warehouses de grande porte, arquitetura Spark ou Databricks, streaming em escala Kafka, migrações complexas e outros sistemas avançados de engenharia de dados requerem escopo separado e uma oferta personalizada.
Devo entrar em contato com você antes de fazer o pedido?
Sim. Por favor, envie uma mensagem primeiro com sua fonte de dados, destino, dados de exemplo e fluxo de trabalho desejado para que eu possa confirmar o pacote e escopo corretos.