Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Profissional sênior em Dados e IA
Páginas web desorganizadas, feeds ou contas do Instagram transformados em uma tabela limpa, deduplicada, que você pode consultar, atualizada periodicamente, com um painel ou API por cima.
A diferença de um scraper comum: uma etapa de IA lê cada item e preenche os campos que regexes não conseguem, como categoria, faixa de preço, sentimento, entidades ou a data do evento escondida na legenda. A saída é validada contra o esquema antes de chegar ao banco de dados, então respostas malformadas falham de forma clara ao invés de poluir seus dados.
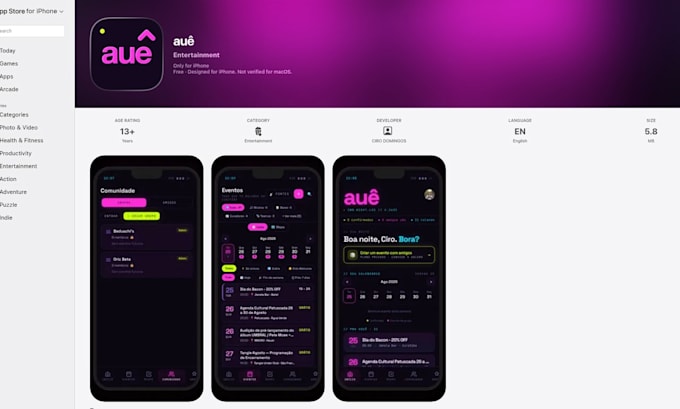
Prova: meu app de eventos ingere cerca de 80 contas do Instagram via Apify e usa Claude para extrair campos de eventos de posts e imagens todos os dias. Meu scraper de marcas faz o mesmo para atributos de marcas. Ambos os links estão no meu perfil.
O que você recebe: a pipeline implantada no Railway ou no seu host, a tabela em SQLite ou Postgres, um painel Streamlit ou um endpoint FastAPI, e o custo de cada execução registrado.
Como começamos: envie duas páginas de exemplo e as colunas que deseja. Você recebe uma tabela de amostra com 100 linhas antes da execução completa.
Não incluído: sites que proíbem scraping em seus termos, logins, captchas.
Tecnologia:
Python
•
Planilhas Google
•
selenium
•
dramaturgo
•
Pandas
Técnica:
Automatizado
Tradução automática
Pode rodar no meu servidor?
Sim, ou no Railway sob sua conta.
Qual é o custo de operação?
Normalmente abaixo de $20 por mês; cada execução registra seu custo.