Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
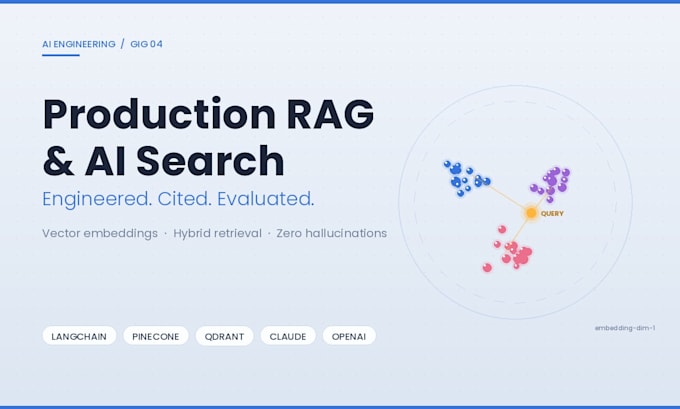
A maioria dos "chatbots RAG" no Fiverr são entregues como demos:
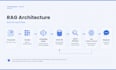
um PDF, chunking fraco, sem avaliação de recuperação, alucinações por toda parte. Eu construo sistemas RAG de nível de produção projetados para entregar citações, avaliações e monitoramento.
O QUE EU VOU CONSTRUIR:
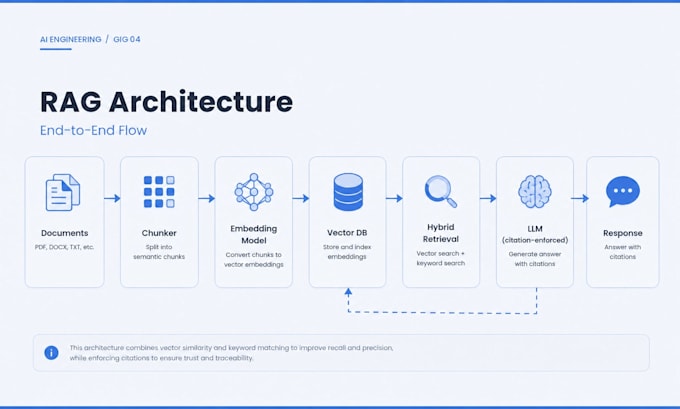
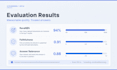
Arquitetura RAG personalizada (LangChain, LlamaIndex ou Python puro) Configuração de banco de dados vetorial (Pinecone, Qdrant, Weaviate, pgvector, Chroma) Pipeline inteligente de chunking + embedding (OpenAI, Cohere, BGE) Recuperação híbrida densa + esparsa + reranking para recall@k real Citação de cada afirmação que remete a uma fonte múltiplos modelos de orquestração (Claude, GPT-4o/5, Gemini) Estrutura de avaliação (Ragas, avaliações personalizadas) você sabe que funciona Observabilidade (LangSmith ou logs personalizados) FastAPI / Node endpoint pronto para sua aplicação Hospedagem própria (Docker, seu VPS) ou gerenciada (Pinecone)
PARA QUEM EU CONSTRUIR:
Fundadores de SaaS adicionando busca IA / Q&A Equipes de desenvolvimento que precisam de RAG que funcione em produção Bases de conhecimento internas (Notion, Confluence, S3) Startups substituindo busca por palavra-chave por busca semântica
POR QUE ME CONTRATAR:
RAG que não alucina avaliado, citado, monitorado Código bem documentado que sua equipe consegue manter Tempo de resposta de 1 hora Envie seus documentos + caso de uso. Plano escopo em 1 hora.
AI Voice Agent Developer, Vapi, Bland AI, Twilio, GPT4o
Idiomas
Tradução automática
Tradução automática
Qual a diferença entre um "demo RAG" e um "produção RAG"?
Um demo RAG incorpora um PDF, recupera os k melhores chunks e usa um LLM — funciona com documentos tutoriais e falha com dados reais. Um produção RAG tem chunking inteligente ajustado ao seu domínio, recuperação híbrida (não só similaridade cosseno), reranking, aplicação de citações, avaliação contra Q de verdade.
Qual banco de dados vetorial devo usar — Pinecone, Qdrant, Weaviate ou pgvector?
Pinecone é o mais rápido para implantação (gerenciado, sem operações) — melhor quando você quer lançar em dias. Qdrant hospedado por você é a melhor opção gratuita que escala. Weaviate é forte em busca híbrida com filtragem de metadados. pgvector é ideal se você já usa Postgres e quer vetores ao lado dos seus dados relacionais.
Como você evita alucinações?
Três camadas. (1) Aplicação de citações — o LLM deve citar o chunk recuperado para cada afirmação, e saídas sem citações são sinalizadas. (2) Validação de recuperação — scores de confiança na recuperação, então perguntas de baixa confiança retornam "Não tenho informações suficientes" ao invés de adivinhar. (3) Cross-mo
Você consegue hospedar todo o sistema na minha infraestrutura?
Sim. Configuração completa com Docker compose: Qdrant ou Weaviate para vetores, FastAPI para o serviço, sua escolha de endpoint LLM (API OpenAI, API Anthropic ou Llama/Mistral hospedado por você via Ollama ou vLLM). Útil quando há restrições de conformidade ou você não quer dependência de fornecedor. Incluído a partir do plano Standard.