Ver categorias
Explorar
Fiverr Pro
Português
$
USD
web scraping, data mining, apify, extração de dados, automação, coleta de dados
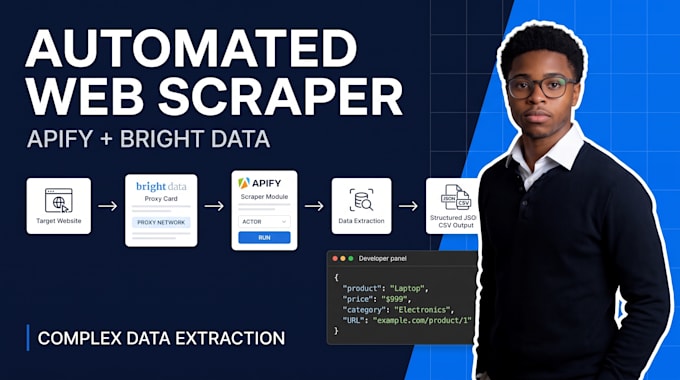
Seu projeto de dados é muito complexo para um scraper básico?
Páginas dinâmicas, conteúdo em JavaScript, paginação, estruturas complexas de sites, extrações recorrentes e grandes conjuntos de dados podem tornar abordagens simples de scraping pouco confiáveis.
Vou criar um scraper automatizado feito sob medida para o seu site, suas necessidades de dados e seu fluxo de trabalho.
Usando técnicas adequadas de scraping e automação, posso trabalhar com páginas estáticas ou dinâmicas, dados estruturados de produtos, listagens, diretórios, dados de pesquisa e outras informações acessíveis ao público.
A solução pode incluir limpeza de dados, saída estruturada, automação reutilizável, coleta recorrente, integração com API, armazenamento em banco de dados ou outros requisitos do fluxo de trabalho, dependendo do seu projeto.
Seus dados finais podem ser entregues em formatos compatíveis com CSV, Excel, Google Sheets, JSON, banco de dados ou API.
Este serviço é adequado para empresas, agências, pesquisadores, equipes de e-commerce, desenvolvedores e clientes com projetos de extração tecnicamente desafiadores.
Por favor, envie uma mensagem antes de fazer o pedido com o site alvo, campos necessários e escopo do projeto, assim posso revisar os requisitos técnicos primeiro


Tecnologia:
JavaScript
•
Python
•
Excel
•
NodeJS
•
dramaturgo
Técnica:
Automatizado
Tradução automática
Você consegue fazer scraping de sites dinâmicos com JavaScript?
Sim. Posso usar técnicas adequadas de automação de navegador ou scraping para conteúdo carregado dinamicamente
Você consegue lidar com paginação e scroll infinito?
Sim. Fluxos de trabalho de paginação e scroll podem ser incluídos quando suportados pelo site alvo
Você consegue criar um scraper reutilizável ao invés de apenas entregar os dados?
Sim. Um scraper ou fluxo de automação reutilizável pode ser desenvolvido quando necessário
Você consegue fazer scraping de múltiplos sites em um projeto?
Sim. Múltiplas fontes podem ser suportadas dependendo da estrutura e da complexidade do projeto
Você consegue limpar os dados extraídos?
Sim. Limpeza, formatação, normalização e remoção de duplicatas podem ser incluídas
Você consegue conectar os dados raspados a um banco de dados?
Sim. Armazenamento em banco de dados pode ser incluído em projetos adequados
Você consegue fornecer saída via API?
Sim. Entrega ou integração via API podem ser consideradas dependendo do fluxo de trabalho
Você consegue automatizar a coleta recorrente de dados?
Sim. Extrações recorrentes podem ser configuradas quando o projeto requer dados atualizados continuamente
Você consegue lidar com projetos de scraping grandes?
Sim. Projetos maiores podem ser avaliados com base na complexidade da fonte, volume de dados, frequência, infraestrutura e requisitos de processamento
Você consegue revisar um site difícil antes de eu fazer o pedido?
Sim. Por favor, envie a URL do site, campos necessários, volume esperado e saída preferida para que eu possa avaliar o projeto antes de você fazer o pedido