Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Agência
Tradução automática
AJUSTE FINO DE LLM PERSONALIZADO | IA PRIVADA
Modelos de IA genéricos podem inventar fatos de domínio, perder seu contexto de negócio ou criar preocupações de privacidade.
A SOLUÇÃO
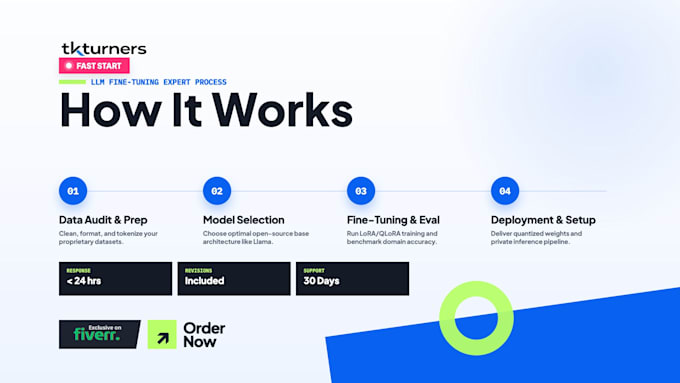
Fazemos o ajuste fino de LLMs de código aberto como Llama 3, Mistral & Qwen nos seus dados proprietários, fluxos de trabalho e tom de marca para desempenho especializado, mantendo seus dados privados.
POR QUE TKTURNERS
Engenharia de IA full-stack com LoRA/QLoRA, curadoria de datasets especializada, conformidade com NDA e manipulação segura/air-gapped de dados.
O QUE ENTREGAMOS
GARANTIA DE QUALIDADE
Iteramos até que o modelo atinja as métricas de benchmark acordadas.
AUDITORIA GRATUITA
Envie uma mensagem antes de pedir para uma auditoria gratuita do dataset e roteiro de arquitetura de IA.

Agência
20 de funcionários
Idiomas
Tradução automática

MEETOVO

S&D Moving

Empowering Confident Youth
Education Services
Tradução automática
Por que devo enviar uma mensagem antes de fazer um pedido?
O ajuste fino depende bastante do tamanho do seu dataset, formato e caso de uso alvo. Entrar em contato primeiro garante que verificamos a viabilidade dos seus dados e escolhemos a arquitetura de código aberto mais econômica.
Como você garante que meus dados empresariais proprietários permaneçam confidenciais?
Seus dados são totalmente seus. Executamos NDAs empresariais, usamos ambientes de computação privados e air-gapped, e deletamos todos os dados de treinamento imediatamente após a conclusão do projeto.
Quais modelos de código aberto você pode ajustar fino?
Trabalhamos com os principais modelos de código aberto, incluindo Llama 3/3.1, Mistral/Mixtral, Qwen 2.5, Phi-3, Gemma 2 e modelos especializados de código/embedding.
Quem cobre os custos de GPU e treinamento na nuvem?
Custos de computação (por exemplo, RunPod, Lambda Labs, AWS EC2 ou Colab Pro) são pagos diretamente pelo cliente. Otimizamos o treinamento usando QLoRA para manter os custos de computação geralmente abaixo de US$ 10–50.
Qual formato de dado preciso fornecer?
Aceitamos JSONL, CSV, texto bruto, Markdown, PDFs ou pares de instrução-resposta. Se seus dados forem não estruturados, podemos limpá-los e formatá-los em datasets de instruções de alta qualidade.
Em que formato meu modelo ajustado fino será entregue?
Fornecemos pesos de adaptadores PEFT/LoRA, safetensors mesclados, arquivos GGUF quantizados para Ollama/LM Studio ou um serviço vLLM/FastAPI containerizado.
Que acesso você precisa de mim para começar a trabalhar?
Precisamos do seu dataset de amostra/completo e acesso à sua instância de GPU na nuvem preferida (RunPod, Hugging Face ou AWS) ou ambiente local.
O que está incluso nas revisões?
Revisões incluem ajustes de hiperparâmetros (taxa de aprendizado, épocas, classificação), reavaliação em conjuntos de validação personalizados e conversão de formato de exportação.
Você pode integrar o modelo ajustado fino na minha aplicação web ou API existente?
Sim. Como uma agência de engenharia full-stack, construímos microserviços FastAPI, containers Docker e frontends Next.js/Node.js para servir seu modelo de forma eficiente.
Você oferece suporte e manutenção após a entrega?
Sim. O nível Premium inclui 14 dias de suporte. Também oferecemos pacotes de manutenção contínua para re-treinamento, atualizações de dataset e escalonamento de servidores.