Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Desenvolvedor Web Full Stack: WordPress, OCR, Integração de API, Sites de Peptídeos
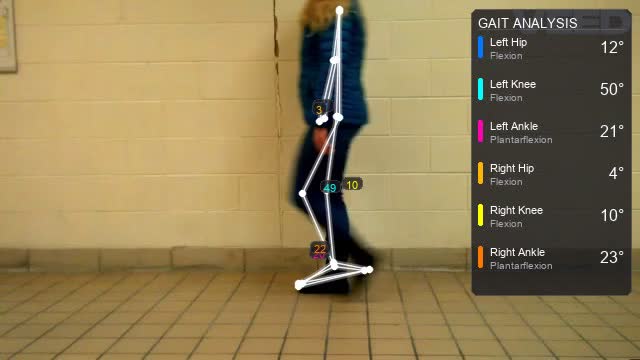
Precisa automatizar rastreamento visual, extrair dados ou lançar um aplicativo de IA?
Análises manuais de vídeos e manipulação de documentos custam tempo ao seu negócio. Eu crio sistemas de IA de visão computacional e OCR de alto desempenho para resolver seus gargalos e transformar dados visuais em insights acionáveis.
Seja para um aplicativo de visão computacional ou detecção de objetos independente ou uma pipeline de extração de dados, entrego softwares robustos, prontos para implantação, adaptados ao seu fluxo de trabalho.
PROBLEMAS QUE RESOLVO:
TECNOLOGIAS & FERRAMENTAS:
POR QUE ESCOLHER ESTE GIG?
Envie uma mensagem antes de pedir para discutir seu dataset!
Linguagem de programação:
Python
•
MATLAB
•
SQL
•
Colab
•
MLflow
Frameworks:
Scikit-learn
•
Google ML Kit
•
SimpleCV
•
PyTorch
•
Panda
Tradução automática
O que preciso fornecer para começar a construir meu aplicativo de visão computacional ou detecção de objetos?
Por favor, forneça seu dataset (imagens, vídeos ou digitalizações de documentos) e uma explicação clara sobre quais objetos ou textos você quer que o sistema de IA de visão computacional e OCR rastreie ou extraia. Se ainda não tiver dados, posso ajudar na coleta e configuração de frameworks personalizados.
Quais frameworks e modelos de deep learning você usa para o desenvolvimento?
Principalmente escrevo scripts de IA em Python limpos usando OpenCV para feeds de vídeo em tempo real, junto com PyTorch e TensorFlow para treinamento de modelos. Para alta velocidade e precisão, implemento arquiteturas de última geração como YOLOv8 e YOLOv11 para garantir resultados de alta qualidade.
Seu sistema de OCR consegue lidar com texto manuscrito ou documentos complexos?
Sim, o sistema inteligente de OCR é configurado usando engines robustas (como Tesseract, EasyOCR ou APIs de visão na nuvem) adaptadas para ler layouts de múltiplas colunas, faturas digitais e campos de texto complexos, convertendo arquivos brutos em pipelines de dados estruturados e pesquisáveis.
O aplicativo finalizado roda localmente ou pode ser implantado na nuvem?
Ambos! Dependendo da sua necessidade, posso entregar sua solução como uma ferramenta leve de desktop, empacotá-la em containers Docker para servidores na nuvem (AWS/GCP), ou criar uma interface de aplicativo web de IA totalmente interativa usando ferramentas modernas de dashboard em Python como Streamlit.
Como você garante a precisão do rastreamento de objetos e segmentação de imagens?
Cada pipeline passa por testes rigorosos de validação usando métricas de avaliação de machine learning personalizadas. Ajusto rigorosamente os limiares de confiança, elimino falsos positivos e refino as máscaras de segmentação de imagem até que o sistema atinja a precisão de produção que você precisa.