Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Level 2


Tradução automática
AJUSTE FINO DE LLM PERSONALIZADOS
Modelos genéricos de IA podem criar alucinações ou falhar nos seus fluxos de trabalho. Ajuste-os com seus dados proprietários, formatação e conhecimento de domínio.
ENTREGAS & VELOCIDADE
A SOLUÇÃO
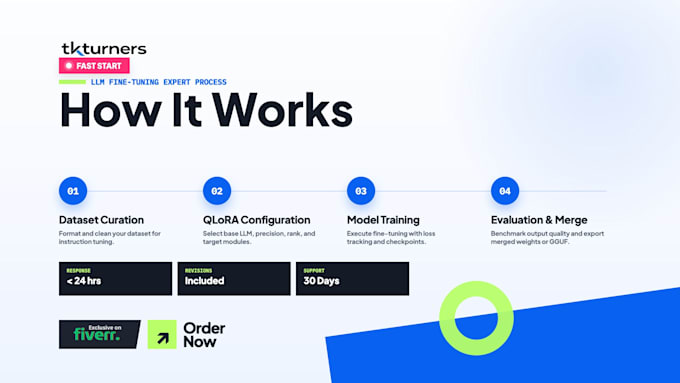
Construímos datasets de instruções limpos, otimizamos parâmetros rank/alpha e ajustamos modelos para melhor desempenho em domínio e custos de inferência menores.
POR QUE TKTURNERS
Engenheiros de IA full-stack entregando modelos prontos para produção e automação de fluxo de trabalho sob medida para suas necessidades de negócio.
GARANTIA DE QUALIDADE
Cada modelo é avaliado com prompts de teste acordados. Se os resultados não atingirem as métricas, retreinamos sem custo adicional.
AUDITORIA GRATUITA DE IA
Envie uma mensagem antes de pedir para uma auditoria gratuita de 15 minutos no dataset & recomendação de arquitetura do modelo.
Senior Software Engineer
Level 2
Idiomas
Tradução automática
Tradução automática
Por que devo enviar uma mensagem antes de fazer o pedido?
Entrar em contato antes nos permite avaliar o tamanho do seu dataset, verificar compatibilidade com o modelo base (por exemplo, Llama 3, Mistral) e confirmar os requisitos de computação para que você receba o pacote exato.
Quais arquiteturas de LLM base você suporta para ajuste fino?
Suportamos Llama 3/3.1, Mistral, Mixtral, Gemma 2, Qwen 2.5, DeepSeek, Falcon e qualquer modelo de pesos abertos hospedado na Hugging Face.
Qual a diferença entre LoRA e QLoRA?
LoRA treina matrizes de adaptadores de baixa classificação para adaptar um modelo de forma eficiente. QLoRA quantiza o modelo base para precisão de 4 bits durante o treinamento, reduzindo drasticamente os requisitos de VRAM da GPU enquanto mantém a precisão máxima do modelo.
Quem cobre os custos de computação GPU e infraestrutura na nuvem?
Custos de computação (RunPod, Lambda Labs, Google Colab Pro ou Hugging Face Inference Endpoints) são pagos diretamente pelo cliente. Orientamos você sobre a configuração de GPU mais econômica.
Em que formato meu dataset deve ser fornecido?
Você pode fornecer seus dados em JSON, JSONL, CSV ou texto bruto. Nós limpamos, validamos e convertemos para formatos de instruções padrão como Alpaca, ShareGPT ou ChatML.
Quais entregas exatas vou receber ao final do projeto?
Você receberá pesos treinados do adaptador LoRA, o modelo standalone mesclado (se solicitado), arquivos GGUF quantizados para Ollama/LM Studio, scripts de teste e métricas de avaliação.
Você pode implantar o modelo ajustado em uma API ou nuvem privada?
Sim. Podemos implantar seu modelo treinado em Hugging Face Endpoints dedicados, servidor sem servidor RunPod, vLLM, Ollama ou backend FastAPI personalizado na AWS/GCP.
Que acesso a API ou plataforma de terceiros você precisará?
Podemos precisar de acesso de leitura/gravação à sua conta Hugging Face (token de acesso) e à sua plataforma de nuvem GPU escolhida (RunPod, Lambda Labs ou AWS) via chaves de API ou credenciais temporárias.
Como você lida com revisões e desempenho de benchmark?
Cada nível inclui revisões para ajustar taxas de aprendizado, épocas ou parâmetros rank/alpha. Avaliamos seu modelo com conjuntos de validação para verificar a qualidade.
Você oferece suporte e manutenção após a entrega?
Sim, oferecemos manutenção contínua e suporte de retainer para ingestão periódica de datasets, retrain de modelos e escalonamento de inferência na nuvem.