Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Software Sênior em POS, ERP e soluções web e mobile com IA
Precisa que seu LLM seja implantado em produção de forma rápida, otimizada e econômica?
Você está no lugar certo!
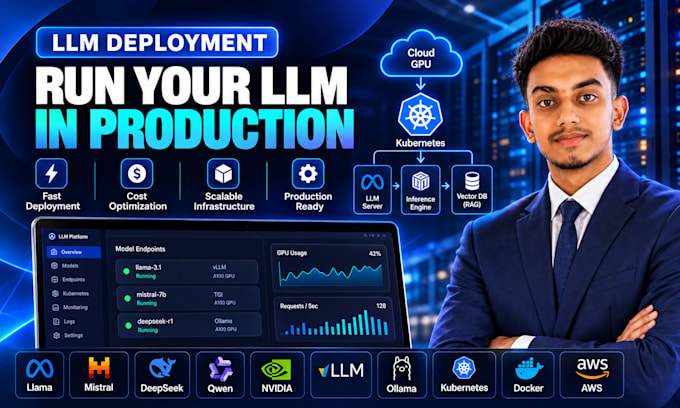
Eu implanto e configuro LLMs de código aberto em servidores na nuvem com GPU e Kubernetes, com motores de inferência ajustados para respostas rápidas e custos menores de GPU.
O que eu ofereço:
Pilha tecnológica:
Inferência: vLLM || TGI || Ollama || NVIDIA Triton || TensorRT-LLM || llama.cpp || SGLang
Modelos: Hugging Face || Llama || Mistral || Qwen || DeepSeek
Cloud & GPU: AWS || Google Cloud || Azure || RunPod || Lambda Labs
Containers: Docker || Kubernetes || Helm
Monitoramento: Prometheus || Grafana
Por que me escolher?
Vamos colocar seu LLM no ar hoje mesmo!
Tradução automática
Quais LLMs você pode implantar?
Qualquer modelo de código aberto do Hugging Face, incluindo Llama, Mistral, Qwen, DeepSeek, Gemma e Phi, assim como modelos ajustados ou personalizados que você fornecer.
O que inclui a configuração do motor de inferência?
Configurar e ajustar vLLM, TGI, Triton ou Ollama para seu modelo: memória GPU, batching, comprimento de contexto, cache KV, paralelismo de tensor e quantização, para respostas mais rápidas e menor custo.
Qual motor de inferência devo usar?
vLLM para APIs de alta vazão, TGI para modelos do Hugging Face, Triton ou TensorRT-LLM para desempenho máximo em GPUs NVIDIA, e Ollama ou llama.cpp para setups menores ou em CPU. Vou recomendar a melhor opção.
Você consegue reduzir meus custos com GPU?
Sim. Com quantização (AWQ, GPTQ, GGUF), batching e dimensionamento adequado de GPUs, posso rodar o mesmo modelo em hardware mais barato com qualidade semelhante.
A API vai funcionar como a da OpenAI?
Sim. Posso configurar uma API compatível com OpenAI, assim você pode trocar seu app atual da OpenAI pelo seu próprio LLM mudando apenas a URL base e a chave API.
Quem paga pelos custos de GPU e nuvem?
Custos de GPU e hospedagem são cobrados pelo provedor (AWS, GCP, Azure, RunPod, etc.) na sua própria conta. Vou ajudar você a escolher a GPU mais econômica para seu modelo e tráfego.
Meu modelo e dados são privados?
Sim. Seu LLM roda nos seus próprios servidores, então prompts e dados nunca vão para APIs de terceiros. Também protejo o endpoint com chaves API, SSL e regras de firewall. Posso assinar um NDA se precisar.
O que preciso fornecer antes de começarmos?
O modelo que você quer (ou seus requisitos), acesso à sua conta na nuvem ou GPU, tráfego esperado e qualquer domínio que queira usar. Se estiver em dúvida, ofereço uma consulta gratuita.
Você consegue implantar um modelo que eu ajustei?
Sim. Compartilhe seus pesos do modelo ou repositório no Hugging Face, e eu vou implantar e otimizar com o motor de inferência adequado.
Não tem certeza de qual pacote se encaixa no seu projeto?
Me envie uma mensagem antes de pedir. Vou revisar seu modelo e necessidades de tráfego e recomendar o pacote certo ou enviar uma oferta personalizada.
