Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro IA Fine Tuning de LLM com LoRA e QLoRA
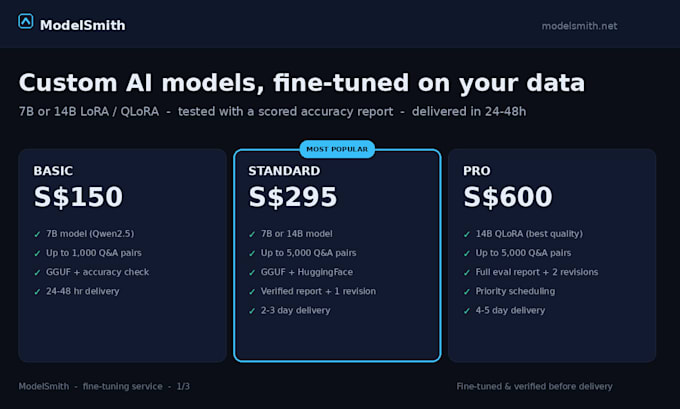
Eu afino modelos IA de 7B e 14B com seus dados. Não templates de prompt — modelos LLM reais, ajustados, treinados com suas perguntas e respostas, testados antes da entrega e enviados no formato de que você precisa.
O que eu faço:
- Fine-tuning LoRA / QLoRA de modelos 7B ou 14B (Qwen2.5 por padrão)
- Treinado com 100 a 5.000 pares de Q e A seus
- Verificado com um relatório de acurácia com perguntas retidas
- Entregue como GGUF (Ollama, llama.cpp) ou HuggingFace (vLLM, Transformers)
Por que é diferente:
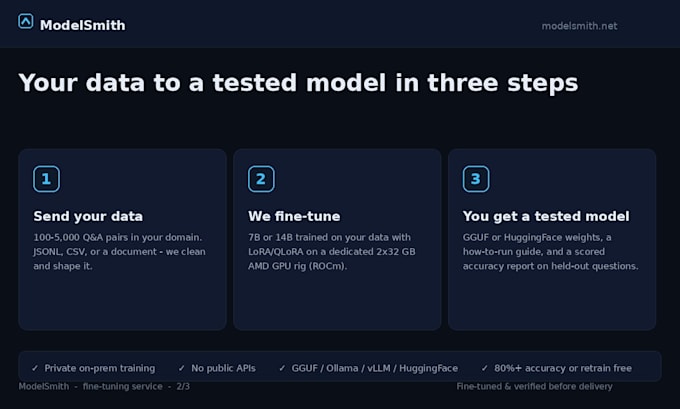
A maioria dos gigs de fine-tuning entrega um arquivo e deseja boa sorte. Eu testo primeiro. Cada modelo vem com um relatório de acurácia com seus dados retidos — 80% ou mais, ou eu retrabalho sem custo.
Privacidade:
Execuções de treinamento em um rig privado com 2x32 GB de GPU. Seus dados nunca vão para uma API pública e são apagados na entrega, a menos que peça para manter.
Velocidade:
Um LoRA 7B treina em menos de uma hora de computação. A maioria dos projetos é entregue em 24 a 48 horas.
Envie seu conjunto de dados e eu terei um modelo testado pronto em poucos dias.


Linguagem de Programação:
Python
•
Pytorch
•
Outros
Estruturas e ferramentas para modelos de IA:
Tipo de dados:
Texto
•
Tabular Data
•
Outros
Motor de IA:
Llama
•
PyTorch
•
Outros
Tradução automática
Qual modelo você usa?
Qwen2.5-7B-Instruct por padrão para o nível 7B. Qwen2.5-14B-Instruct para 14B. Modelos Mistral e Llama disponíveis mediante solicitação.
O que preciso te enviar?
100 a 5.000 pares de Q e A em qualquer formato: JSONL, CSV, ou até mesmo um documento. Vou limpar e estruturar.
Como isso é diferente de um template de prompt ou prompt de sistema?
Um template de prompt instrui um modelo genérico. Um fine-tune altera os pesos do modelo para que ele conheça suas respostas de forma nativa. Melhor acurácia, sua voz, menor overhead de prompt.
Meus dados estão seguros?
Sim. O treinamento ocorre em um rig local privado 2x32 GB. Não em uma API pública. Deixo o conjunto de dados pronto na entrega, a menos que peça para manter.
O que exatamente recebo?
Pesos do modelo (GGUF e/ou HuggingFace), um guia de como rodar com comandos exatos para o seu runtime (Ollama, llama.cpp, vLLM) e um relatório de acurácia com pontuação.
E se o modelo não funcionar bem?
Padronizado inclui 1 revisão gratuita, Premium 2. Se a avaliação com dados retidos não atingir a sua meta de acurácia, eu retrabalho sem custo.
Quanto tempo a entrega demora?
7B: 24-48 horas. 14B: 2-5 dias. O prazo começa quando seu conjunto de dados é confirmado.
Eu preciso de minha própria GPU ou hardware?
Não. Eu cuido de todo o treinamento no meu rig. Você só precisa de hardware para rodar o modelo final (qualquer CPU pode rodar um 7B GGUF, ou usar Ollama).