Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
Você está cansado de tutoriais genéricos e dados desorganizados que não resolvem seu problema real? Precisa de um modelo de Machine Learning ou Deep Learning personalizado, rigorosamente validado?
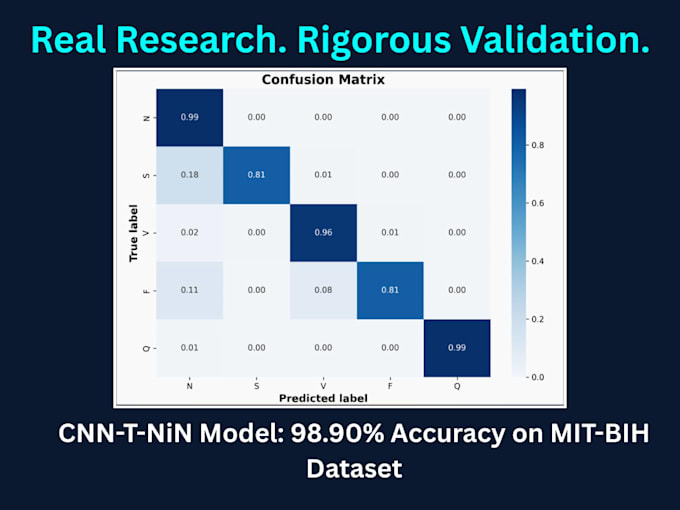
Sou pesquisador de IA com mestrado em Ciência da Computação (IA) pela COMSATS University. Minha pesquisa publicada foca em deep learning para classificação de sinais de ECG, e construí um assistente de negociação de IA que melhora sozinho e está em produção.
Especializo-me em criar arquiteturas personalizadas de Deep Learning (CNNs, Transformers) em PyTorch, Machine Learning tabular (Random Forest, XGBoost) com ajuste de Optuna, e protocolos de validação rigorosos (validação cruzada de 5 dobras a nível de paciente, LOSO, walk-forward).
Não apenas treino modelos; valido-os de forma rigorosa com validação cruzada e relatórios honestos, garantindo que sua solução funcione de forma confiável no mundo real.
Meus serviços incluem:
Por favor, envie uma mensagem antes de fazer o pedido para que possamos discutir seu dataset, objetivos e desafios. Vamos construir algo que funcione.
AI and Machine Learning Expert, Python Automation
Idiomas
Tradução automática
Tradução automática
Quais ferramentas e estruturas você usa?
Eu uso principalmente PyTorch para deep learning, e Scikit-Learn, XGBoost e Pandas para dados tabulares e pré-processamento. Também uso Optuna para ajuste de hiperparâmetros e SHAP para explicabilidade.
O que você precisa de mim para começar?
Preciso do seu dataset (CSV, Excel ou acesso a banco de dados), uma descrição clara do seu objetivo (por exemplo, classificação, regressão, séries temporais) e a variável alvo que deseja prever.
Você faz pré-processamento de dados?
Sim. Pré-processamento padrão (tratamento de valores ausentes, normalização, reshaping e tratamento de desequilíbrio de classes) está incluído nos pacotes Standard e Premium.
Você fornece documentação e código fonte?
Os pacotes Standard e Premium incluem código fonte completo, comentários no código e um relatório detalhado de desempenho. Se precisar de documentação adicional no pacote Basic, você pode adicioná-la como extra no serviço.