Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de dados
Precisa de um Engenheiro de Dados Sênior para pipelines ETL/ELT escaláveis, processamento de Big Data, Data Warehousing ou arquiteturas Lakehouse?
Sou Muhammad Ahmed, um Engenheiro de Dados com mais de 4 anos de experiência construindo plataformas de dados de nível empresarial em ecossistemas AWS, Azure, GCP e Snowflake.
Serviços que ofereço:
Tecnologias:
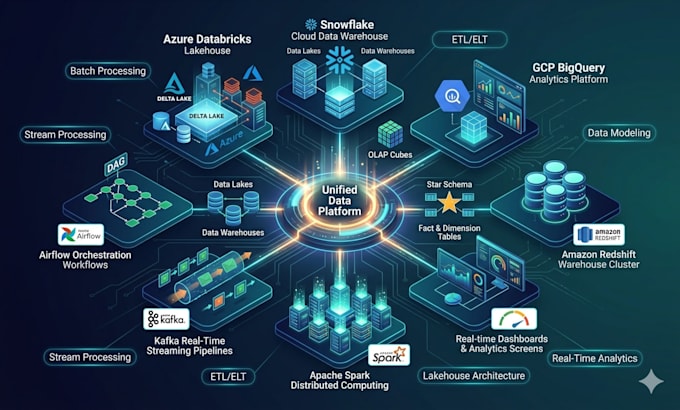
Azure Databricks, Snowflake, GCP BigQuery, Amazon Redshift, Apache Spark, PySpark, Kafka, Airflow, DBT, Snowflake SQL, SparkDF, PostgreSQL, AWS, Docker, Python, SQL.
Construo soluções de engenharia de dados escaláveis, confiáveis e nativas da nuvem para análises, relatórios, automação e processamento em tempo real. E forneço dados prontos para IA/ML e análises.
Engenharia de Dados, ETL, ELT, Big Data, PySpark, Airflow, Kafka, Snowflake, Databricks, Data Warehouse, Redshift, BigQuery.
Warehouse Platform:
Snowflake
•
BigQuery
•
Databricks
Tipo de projeto:
New Build
Tradução automática
Quais plataformas de nuvem vocês suportam?
Trabalho com AWS, Azure, GCP, Snowflake, Databricks, Amazon Redshift e BigQuery.
Você constrói pipelines de batch e streaming?
Sim. Desenvolvo pipelines em batch usando Apache Spark e soluções de streaming com Kafka e Spark Streaming.
Você consegue projetar arquiteturas de Data Warehouse e Lakehouse?
Sim. Projetos Data Lakes, Data Warehouses e sistemas Lakehouse escaláveis usando Medallion Architecture e plataformas modernas de nuvem.
Quais ferramentas de orquestração você usa?
Apache Airflow, tarefas Snowflake/Jobs agendados e soluções de agendamento nativas da nuvem.
Você implementa modelagem de dados?
Sim. Trabalho com esquema estrela, snowflake, dimensões, tabelas de fatos, OLAP e OLTP.
Quais tecnologias você usa para processamento de dados?
PySpark, Spark SQL, DBT, Snowflake SQL, SparkDF, Python, SQL, Kafka e ferramentas de processamento nativas da nuvem.
Você consegue otimizar pipelines existentes?
Sim. Posso melhorar o desempenho, escalabilidade, otimização de custos e confiabilidade dos sistemas de engenharia de dados existentes.