Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Dados Sênior
Você está procurando um Engenheiro de Dados experiente para criar pipelines de dados confiáveis e escaláveis?
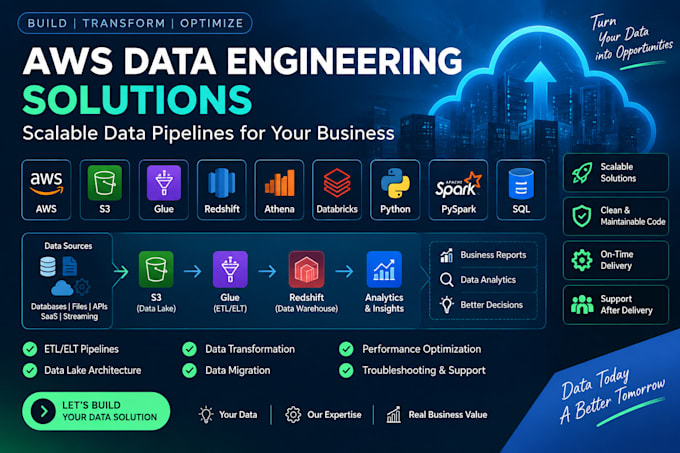
Eu vou desenvolver e otimizar soluções de engenharia de dados na AWS, ETL/ELT e processamento de dados usando Python, PySpark, SQL, AWS Glue, S3, Redshift, Athena e Databricks.
Veja como posso te ajudar:
Meu foco é criar soluções de dados limpas, escaláveis, fáceis de manter e prontas para produção, de acordo com suas necessidades de negócio.
Seja para criar uma nova pipeline de dados, otimizar um fluxo existente ou ajudar na resolução de problemas no seu projeto de engenharia de dados, posso ajudar.
Tecnologias: AWS | Python | PySpark | SQL | Glue | S3 | Redshift | Athena | Databricks | Delta Lake
Especialidade:
CI/CD
•
Monitoramento e Logs
•
Automação
Provedor de nuvem:
Amazon Web Services
