Ver categorias
Português
$
USD
Conecte-se à sua IA
Análise de dados da AbyssalAnalytics por um colega biólogo
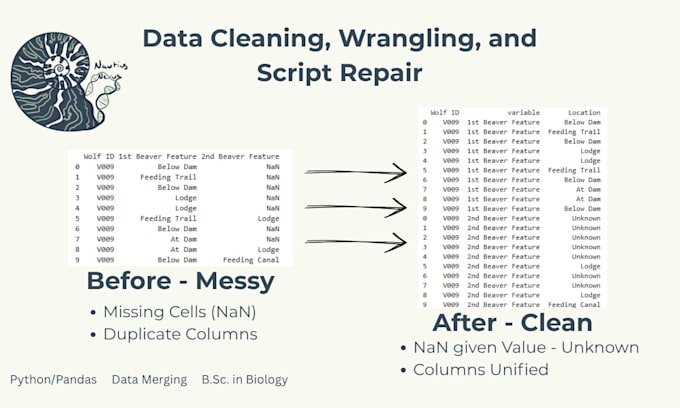
Você é estudante de pós-graduação, pesquisador ou acadêmico com código quebrado ou um conjunto de dados bagunçado? Como analista de dados com bacharelado em Biologia e minor em Ciência Psicológica, eu entendo que seus dados representam horas de observações meticulosas e trabalho físico, e não são apenas planilhas corporativas. Especializo-me na execução mecânica da limpeza de dados para você poder se concentrar totalmente na sua tese, diretrizes do comitê ou outras questões urgentes.
O que eu faço:
Depuração de código: Corrigir erros de sintaxe, loops ou avisos de layout nos seus Jupyter Notebooks.
Wrangling de dados: Reestruturar formatos brutos, tratar células ausentes e normalizar categorias de texto.
Integração multi-fluxo: Sincronizar até 3 logs ou planilhas separadas em um único conjunto de dados unificado.
Observação: para proteger a integridade dos dados, seu arquivo bruto e hipóteses de pesquisa ficam congelados assim que o pedido é iniciado.
Para conjuntos de dados massivos que excedem os limites de linhas, use o extra 'Extra Data or File' no checkout. Para um notebook de projeto adicional, escolha o mesmo. Se quiser uma explicação do código, selecione 'Code Documentation'.
Confira meu código público em github.com/skyegambrel
Tradução automática
Que formatos de arquivo específicos você aceita para limpeza de dados?
Aceito formatos padrão de dados tabulares, incluindo CSV, XLSX (Excel), TSV e TXT, bem como arquivos de script Jupyter Notebook (.ipynb) para depuração. Por favor, garanta que as estruturas de seus arquivos não estejam criptografadas antes de enviá-los ao painel de requisitos.
O que conta como uma única 'Item Cleaned' ou arquivo de dataset?
Um único item refere-se a uma planilha standalone, tabela de dados ou notebook de código-fonte. Tier 1 cobre um único script com falha, Tier 2 cobre um único arquivo de dados brutos (até 200 linhas) e Tier 3 cobre a limpeza e integração estrutural de até 3 arquivos separados.
Como você lida com valores ausentes, células em branco ou NaNs no meu conjunto de dados?
• Uso bibliotecas Python especializadas (Pandas e NumPy) para identificar padrões de dados ausentes. Conforme suas instruções, vou criar pipelines limpos para remover linhas vazias, isolar lacunas estruturais ou imputar categorias ausentes com base nos requisitos do seu projeto—sem fabrication.
Você vai explicar o código Python ou bibliotecas que usou para limpar meus arquivos?
As camadas básicas entregam o arquivo de dados limpos e o seu script anotado. Se precisar de uma explicação abrangente, linha por linha, em inglês simples sobre as funções Pandas usadas para você defender o pipeline de dados perante seu comitê, selecione o extra 'Code Documentation' no checkout.
Você assinaria Acordos de Confidencialidade (NDAs) ou cláusulas de privacidade de dados?
De acordo com as regras estritas e seguras da plataforma Fiverr, seus arquivos-fonte brutos, notas de observação e hipóteses são tratados como propriedade intelectual confidencial e nunca são compartilhados ou publicados.
