Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de dados
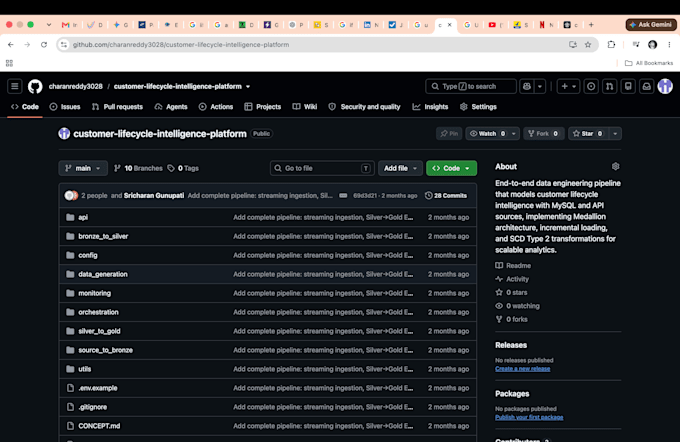
Vou construir pipelines de dados confiáveis e eficientes usando Python, SQL, PySpark e fluxos de trabalho ETL modernos.
Seja com dados em CSV, Excel, JSON, API ou banco de dados, posso ajudar você a extrair, limpar, transformar, validar e preparar esses dados para análises, relatórios ou aplicações downstream.
Meus serviços incluem:
Processamento e automação de dados com Python
Consultas SQL e transformação de dados
Desenvolvimento de pipelines ETL
Processamento de dados com PySpark
Limpeza e validação de dados
Extração de dados via API e arquivos
Integração de dados entre bancos de dados
Transformação de dados e automação de workflows
Documentação básica de pipelines
Foco em escrever código limpo, fácil de manter e eficiente, de acordo com suas necessidades.
Se você tem uma tarefa pequena de dados, um workflow ETL ou uma necessidade maior de pipeline de dados, sinta-se à vontade para me enviar uma mensagem com seus requisitos antes de fazer o pedido. Vou revisar seu projeto e sugerir a abordagem mais adequada.
Warehouse Platform:
BigQuery
Tipo de projeto:
Otimização
