Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Especialista em pipeline de dados com LLM
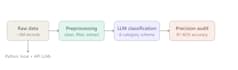
Precisa transformar dados de texto não estruturados em categorias limpas e rotuladas? Eu projeto e construo pipelines de classificação usando grandes modelos de linguagem (locais ou via API) e Python, testados em escala em um projeto que processa cerca de 3 milhões de registros de texto.
O que eu ofereço:
- Esquemas de classificação de texto personalizados, adaptados às suas categorias
- Rotulagem baseada em LLM (modelos locais como Llama, ou APIs como DeepInfra/OpenAI)
- Pipelines de limpeza e pré-processamento de dados em Python
- Auditoria de precisão para você saber o quão confiáveis são os resultados
- Documentação clara da metodologia e dos resultados
Por que trabalhar comigo:
Sou pesquisador de mestrado (Taipei Medical University, GPA 4.0) com experiência prática na construção e validação de sistemas de classificação em grande escala. Me preocupo com precisão, não só velocidade. Cada pipeline que construo inclui uma etapa de validação para que você possa confiar no resultado.
Envie seus dados e categorias, e eu vou definir a abordagem certa para seu projeto.