Ver categorias
Português
$
USD
Conecte-se à sua IA
Desenvolvedor Backend e Especialista em IA Local: Laravel, Python, RAG
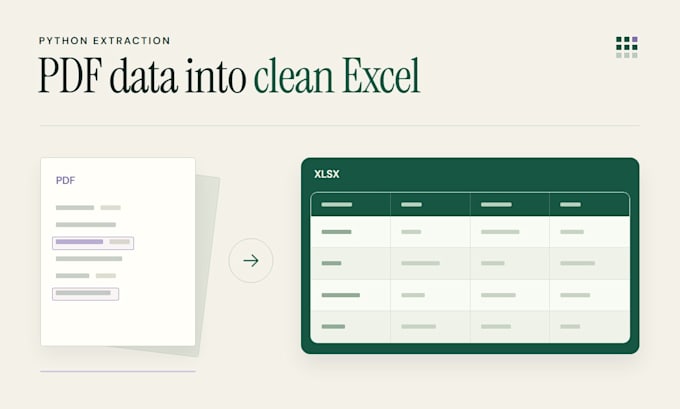
Transforme relatórios PDF repetitivos em um arquivo Excel ou CSV limpo que você realmente pode usar.
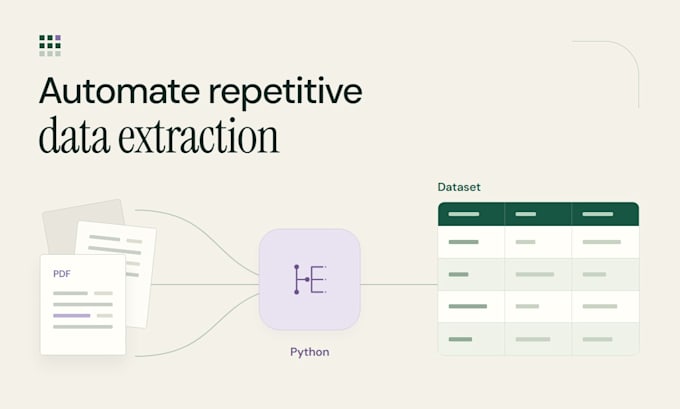
Eu crio fluxos de extração em Python para PDFs legíveis baseados em texto, com layouts consistentes. Você define as colunas; eu mapeio os campos acordados, processo o lote incluído e verifico a estrutura de saída.
O pacote Basic cobre até 20 páginas e um layout. Standard adiciona até 70 páginas, dois layouts e um script Python reutilizável. Premium cobre até 150 páginas e três layouts, com checks de validação acordados e documentação de execução. Limites de campos, arquivos e linhas se aplicam.
Você recebe saída estruturada, um breve resumo da extração e uma lista clara de tudo o que precisa de revisão. Standard e Premium também incluem o script de origem. As saídas são checadas com base no schema acordado; a extração de PDF ainda pode exigir revisão humana.
Por favor, me mande uma amostra redigida de cada layout e as suas colunas-alvo antes de pedir. Scans, escrita à mão, OCR avançado, templates que mudam e regras de negócio complexas exigem uma avaliação separada.
Tecnologia:
Excel
•
Planilhas Google
•
Python
Tradução automática
Quais PDFs você consegue trabalhar?
PDFs legíveis baseados em texto com rótulos de campo ou estruturas de tabela consistentes são a melhor opção. Envie uma amostra redigida de cada layout antes de pedir para eu avaliar a extração e confirmar o pacote.
Isso é entrada manual de dados?
O serviço usa Python para extrair estruturas de dados repetíveis. É voltado para formatos de documentos recorrentes, com um esquema definido e saída checada. Transcrição manual de documentos variados não está incluída nesta oferta
O que é considerado um layout diferente?
Um layout usa os mesmos rótulos de campo, posições de campo e estrutura de tabela. Valores diferentes ou datas costumam estar ok. Uma mudança na estrutura do cabeçalho, campo movido ou nova disposição de tabelas pode exigir lógica de extração separada e contar como outro layout.
O resultado será 100% preciso?
Não há garantia de precisão em porcentagem. Reviro saída representativa, verifico a estrutura acordada e sinalizo exceções detectadas. PDFs podem ter texto ausente ou formatação incomum, então você deve revisar os valores sinalizados antes de confiar nos dados
Você pode lidar com PDFs digitalizados ou escrita à mão?
Scans, PDFs apenas com imagens, escrita à mão, OCR avançado e documentos de baixa qualidade exigem avaliação separada e orçamento personalizado. Não estão incluídos nesses pacotes.